- 25. V příloze části 5 Všeobecné dodatky, kapitola 5.3 zní:
„
5.3 Statistické analýzy výsledků biologických zkoušek
Obsah
- 1 Úvod
- 1.1 Obecný plán zkoušky a přesnost
- 2 Náhodnost a nezávislost jednotlivých ošetření
- 3 Zkoušky závislé na kvantitativní odpovědi
- 3.1 Statistické modely
- 3.1.1 Obecné principy
- 3.1.2 Rutinní zkoušky
- 3.1.3 Výpočty a omezení
- 3.2 Model rovnoběžnosti
- 3.2.1 Úvod
- 3.2.2 Plány zkoušky
- 3.2.2.1 Úplné znáhodnění
- 3.2.2.2 Náhodné bloky
- 3.2.2.3 Latinské čtverce
- 3.2.2.4 Křížová zkouška
- 3.2.3 Analýza rozptylu
- 3.2.4 Test validity
- 3.2.5 Odhad účinnosti a její meze spolehlivosti
- 3.2.6 Chybějící hodnoty
- 3.3 Model poměru sklonů
- 3.3.1 Úvod
- 3.3.2 Plán zkoušky
- 3.3.3 Analýza rozptylu
- 3.3.3.1 Plán (hd + 1)
- 3.3.3.2 Plán (hd)
- 3.3.4 Test validity
- 3.3.5 Odhad účinnosti a její meze spolehlivosti
- 3.3.5.1 Plán (hd + 1)
- 3.3.5.2 Plán (hd)
- 3.1 Statistické modely
- 4 Kvantální zkoušky
- 4.1 Úvod
- 4.2 Probitová metoda
- 4.3.1 Zapisování výsledků
- 4.3.2 Testy validity
- 4.3.3 Odhad účinnosti a její meze spolehlivosti
- 4.3.4 Chybné zkoušky
- 4.3 Logitová metoda
- 4.4 Jiné tvary křivek
- 4.5 Medián efektivní dávky
- 5 Příklady
- 5.1 Model rovnoběžnosti
- 5.1.1 Dvoudávková vícenásobná zkouška úplně znáhodněná
- 5.1.2 Třídávková zkouška s latinskými čtverci
- 5.1.3 Třídávková zkouška s náhodnými bloky
- 5.1.4 Dvojitě křížová zkouška
- 5.2 Model poměru sklonů
- 5.2.1 Úplně znáhodněný plán (0,3,3)
- 5.2.1 Úplně znáhodněný plán (0,4,4,4)
- 5.3 Kvantální zkoušky
- 5.3.1 Probitová analýza, test přípravku proti referenčnímu vzorku
- 5.3.2 Logitová analýza a jiné typy analýzy testu přípravku proti referenčnímu vzorku
- 5.3.3 Stanovení ED50 přípravku pomocí probitové metody
- 5.1 Model rovnoběžnosti
- 6 Kombinace výsledků zkoušky
- 6.1 Úvod
- 6.2 Vážený průměr výsledků zkoušek
- 6.2.1 Výpočet váhových koeficientů
- 6.2.2 Homogenita odhadů účinnosti
- 6.2.3 Výpočet vážených průměrů a mezí spolehlivosti
- 6.2.3 Vážený průměr a meze spolehlivosti založené na vnější a vnitřní individuální variabilitě zkoušky
- 6.3 Nevážená kombinace výsledků zkoušek
- 6.4 Příklad vážené průměrné účinnosti a jejích mezí spolehlivosti
- 7 Další postupy
- 7.1 Obecný lineární model
- 7.2 Heterogenita rozptylů
- 7.3 Odlehlá pozorování a robustní metody
- 7.4 Korelace chyb
- 8 Tabulky a algoritmy
- 8.1 Tabulka kritických hodnot F rozdělení
- 8.2 Tabulka kritických hodnot t rozdělení
- 8.3 Tabulka kritických hodnot χ2-rozdělení
- 8.4 Tabulka kritických hodnot Φ-rozdělení
- 8.5 Náhodné permutace
- 8.6 Latinské čtverce
- 9 Slovník symbolů
- 10 Literatura
- 1 Úvod
Tato stať provádí problematikou plánování a hodnocení biologických zkoušek předepsaných v lékopise. Je určena těm, kteří nejsou profesionální statistici a nezodpovídají za metodiku statistických analýz, ale zodpovídají za analýzu a interpretaci výsledků zkoušek, často prováděných bez pomoci nebo spoluúčasti statistika. Metody popsané v této příloze nejsou závazné pro analýzu výsledků biologických zkoušek, které jsou obsaženy v závazné části lékopisu. Mohou být používány i jiné metody, pokud nejsou méně spolehlivé než ty, které jsou zde popsané. V současné době je dostupné velké množství počítačových programů, jejichž použití je užitečné v závislosti na dostupných možnostech a zkušenosti analytika.
- Odborné statistické návrhy řešení by měly být použity, pokud:
- - je vhodné provést podrobnou analýzu pro účely výzkumu nebo vývoje nového přípravku;
- - je požadována analýza obecné nelineární závislosti odpovědi na dávce, např. při hodnocení imunoesejí;
- - nejsou splněny požadavky stati na plán zkoušky uvedené v této stati, např. dílčí laboratorní omezení mohou vyžadovat speciální plán zkoušky, nebo není možno dodržet požadavek stejných počtů opakování pro ekvidistanční dávky podnětu stejných dávek zkoušky.
- 1.1 Obecný plán zkoušky a přesnost
Biologické metody jsou určeny pro zkoušení látek a přípravků, jejichž účinnost se nedá spolehlivě zjistit chemickými nebo fyzikálními metodami. Všude, kde je to možné, se ve zkouškách užívá princip porovnání se standardním přípravkem. Určuje se množství zkoušeného přípravku, které vyvolá stejný biologický efekt jako dané množství, jednotka referenčního přípravku. Pro tyto metody biologických zkoušek je nezbytné, aby zkouška standardního a zkouška zkoušeného přípravku byly provedeny ve stejném čase a za stejných podmínek.
V některých zkouškách (např. při určení titru virů) není účinnost zkoušeného vzorku vyjádřena relativně vzhledem ke standardu. Tento typ zkoušek je popsán v části 4.5.
Každý odhad účinnosti určený biologickou zkouškou má náhodnou chybu, tkvící v biologické variabilitě odpovědí. Tato chyba by se měla, je-li to možné, stanovit z výsledků každé zkoušky, i pokud je použita oficiální metoda. Metody plánování zkoušek a výpočet jejich chyb jsou proto popsány níže. Vždy před zavedením statistické metody je nutné pomocí předběžné zkoušky stanovit dostatečný rozsah zkoušky (tj. dostatečné množství vzorků).
Interval spolehlivosti pro účinnost udává přesnost, s jakou byla sledovaná účinnost ve zkoušce odhadnuta. Je sestrojen s ohledem na plán a rozsah zkoušky. V biologických zkouškách bývají obvykle používány 95% intervaly spolehlivosti. Pro výpočet hranic intervalů spolehlivosti bývají používány metody matematické statistiky, které zajišťují, že s 95% pravděpodobností tento interval obsahuje skutečnou hodnotu účinnosti. To, zda je tato přesnost přijatelná pro lékopis, závisí na požadavcích popsaných v příslušném lékopisném článku.
Pojmy „průměr“ a „směrodatná odchylka“ jsou zde použity tak, jak jsou definovány v běžných biometrických učebnicích.
- Výrazy „udaná účinnost“ nebo „deklarovaná účinnost“, „referenční účinnost“, „předpokládaná účinnost“, „relativní účinnost“ a „stanovená účinnost“ jsou použity v tomto smyslu:
- - „udaná účinnost“ nebo „deklarovaná účinnost“ označují u předepsaného přípravku jmenovitou hodnotu, určenou ze znalosti účinnosti materiálu, u hromadně vyrobeného materiálu z účinnosti stanovené výrobcem,
- - „referenční účinnost“ - účinnost referenčního přípravku;
- - „předpokládaná účinnost“ - dočasně předpokládaná účinnost zkoušeného přípravku, používá se pro výpočet dávky, jejíž účinek by měl být odpovídající s použitou dávkou referenčního přípravku;
- - „relativní účinnost“ přípravku o neznámé účinnosti je podíl stejně účinných dávek referenčního a zkoušeného přípravku;
- - „stanovená účinnost“ je účinnost vypočítaná z výsledků zkoušky.
V části 9 (Slovník symbolů) je seznam nejdůležitějších symbolů použitých v této příloze. Tam, kde jsou v textu použity symboly, které nejsou popsány v této kapitole nebo jsou použity v jiném smyslu, je to uvedeno v dané části textu.
- Výrazy „udaná účinnost“ nebo „deklarovaná účinnost“, „referenční účinnost“, „předpokládaná účinnost“, „relativní účinnost“ a „stanovená účinnost“ jsou použity v tomto smyslu:
- Odborné statistické návrhy řešení by měly být použity, pokud:
- 2 Náhodnost a nezávislost jednotlivých ošetření
Výběr různých ošetření pro různé pokusné jednotky (zvířata, zkumavky atd.) by se měl provést čistě náhodně. Náhodně by se měl provést i každý jiný výběr pokusných podmínek, nebyl-li pokusným plánem úmyslně jinak stanoven. Příkladem je výběr polohy klecí v laboratoři a pořadí, v němž se provede ošetření. Konkrétně: skupina zvířat, která obdrží stejnou dávku, by neměla být ošetřena společně (ve stejném čase a místě), pokud není spolehlivý důkaz, že tyto zdroje nehomogenity (např. rozdíly v čase nebo místě) jsou zanedbatelné. Náhodné uspořádání může být vytvořeno pomocí v počítačích zabudovaných generátorů náhodných čísel. Analytik si musí ověřit, zda při každém použití příslušného programu získá jinou řadu čísel.
Příprava všech pokusných jednotek má být nezávislá, jak je to nejvíce možné. V každé pokusné skupině nemá být ředění přidělené ke každému ošetření vytvořeno dělením stejné dávky, ale má být připraveno individuálně. Bez tohoto předpokladu by nebyla variabilita tvořená přípravou vzorku plně obsažena ve variabilitě prováděné zkoušky. Výsledkem by bylo podhodnocení reziduální chyby, což má za následek:
- 1. neoprávněný nárůst přesnosti zkoušky v analýze rozptylu (viz části 3.2.3 a 3.2.4),
- 2. podhodnocení skutečných mezí spolehlivosti pro zkoušku, pro kterou byl použit odhad reziduálního rozptylu s2 (viz část 3.2.5).
- 3 Zkoušky závislé na kvantitativní odpovědi
- 3.1 Statistické modely
- 3.1.1 Obecné principy
Biologické zkoušky obsažené v lékopise jsou založeny na principu „ředění“. O neznámém zkoušeném přípravku se předpokládá, že obsahuje stejnou aktivní složku jako referenční přípravek, ale s jiným poměrem aktivní a neúčinné složky. Teoreticky je v tomto případě neznámý přípravek pouze ředěním referenčního přípravku pomocí nějaké neúčinné látky. Má-li se ověřit, zda se konkrétní právě prováděná zkouška řídí tímto modelem, je nutné porovnat závislost odpovědi na ředění přípravku i standardu. Pokud se v prováděné zkoušce výrazně liší průběh závislosti na dávce referenčního a neznámého přípravku, není tento model, užívající princip ředění pro tuto konkrétní zkoušku, vhodný. Významný rozdíl v závislosti na dávce u standardu a zkoušených přípravků může znamenat, že některý z přípravků obsahuje další aktivní složku, která není inertní, ale která ovlivňuje měřenou odpověď.
Aby bylo možno lépe analyzovat vliv ředění na biologickou odpověď, je vhodné transformovat závislost dávka-odpověď na lineární funkci na nejširším možném rozsahu dávek. Pro statistickou analýzu biologických zkoušek jsou určeny dva modely: model rovnoběžnosti a model poměru sklonů.
- Jejich použití je závislé na následujících podmínkách:
- 1. pokusným jednotkám jsou náhodně přidělena jednotlivá ošetření,
- 2. odpověď každého ošetření má normální rozdělení,
- 3. směrodatná odchylka odpovědí v jednotlivých skupinách, jak standardu, tak i neznámého přípravku, se navzájem statisticky významně neliší.
Při navrhování metodiky konkrétní zkoušky musí analytik zajistit, aby data sbíraná v mnoha zkouškách splňovala tyto teoretické předpoklady.
Podmínku 1 lze splnit správným použitím návodu z části 2.
Podmínka 2 je v praxi téměř vždy splněna. Pokud je provedeno více opakování pro každé ošetření, nezpůsobí malé odchylky od tohoto předpokladu obecně vážné selhání těchto metod hodnocení. Při podezření může být proveden test odchylky od normality (např. Shapiro-Wilk test1).
Podmínka 3 může být ověřena testem homogenity rozptylů (např. Bartlettův test2 nebo Cochranův test2). Pro tyto účely je též velmi užitečné použít grafického zobrazení dat (viz příklady v části 5).
Pokud nejsou splněny podmínky 2 a/nebo 3, může se splnění těchto podmínek zlepšit vhodnou transformací. Příkladem je např. , nebo .
- • Logaritmická transformace odpovědi y na ln y, pokud není splněn předpoklad homogenity rozptylů. Transformace též vylepší shodu s předpokladem normality, pokud je rozložení skloněné doprava.
- • Transformace y na je užitečná, pokud pozorování mají Poissonovo rozdělení, tj. pokud pozorované hodnoty představují počty.
- • Transformace y na y2 je vhodná, pokud např. odpověď více odpovídá ploše inhibiční zóny než jejímu průměru.
Existuje ještě další skupina zkoušek, u kterých není možno měřit odpověď každé pokusné jednotky, ale je možné zjistit pouze procento jednotek reagujících na každé testované ošetření. Tyto zkoušky jsou popsány v části 4.
- Jejich použití je závislé na následujících podmínkách:
- 3.1.1 Obecné principy
- 3.1 Statistické modely
- 1 Wilk, M. B. and Shapiro, S. S. (1968). The joint assessment of normality of several independent samples, Technometrics 10, 825-839.
- 2 Bartlett, M. S. (1937). Properties of sufficiency and statistical tests, Proc. Roy. Soc. London, Series A 160, 280-282.
- 3 Cochran, W. G. (1951). Testing a linear relation among variances, Biometrics 7,17-32.
- 3.1.2 Rutinní zkoušky
Pokud je již zkouška prováděna rutinně, lze zřídka možno systematicky ověřovat splnění podmínek 1 až 3, protože omezené množství pozorování ve zkoušce může ovlivnit citlivost statistických testů. Statistici však prokázali, že při symetrickém uspořádání zkoušky neovlivní malé odchylky od předpokladu normality a shody rozptylů výrazně výsledek hodnocení zkoušky. Pokud řada zkoušek dává pochybné výsledky, je nutno opětovně posoudit vhodnost použitého statistického modelu. Pak je nutno provést novou sérii předběžných hodnocení, jak je diskutováno v části 3.1.1.
- Další dvě nezbytné podmínky závisí na zvoleném statistickém modelu:
- Pro model rovnoběžné lineární závislosti:
- 4A) Závislost odpovědi na logaritmu dávky je možno popsat pomocí přímky v rozsahu všech použitých dávek.
- 5A) Pro každý neznámý přípravek musí být přímka závislosti odpovědi na logaritmu dávky rovnoběžná s přímkou závislosti standardu.
- Pro model poměru sklonů:
- 4B) Závislost odpovědi na dávce pro každý přípravek ve zkoušce je možno v rozsahu všech použitých dávek popsat pomocí regresní přímky.
- 5B) Pro všechny zkoušené přípravky musí regresní přímky protínat osu y (v dávce nula) ve stejném bodě jako přímka referenčního přípravku (tj. regresní funkce všech přípravků ve zkoušce musí mít stejný průsečík s osou y jako regresní přímka standardu).
Podmínky 4A a 4B je možno v rámci zkoušky ověřit pouze, pokud je každý přípravek ve zkoušce testován alespoň ve třech ředěních. Provádění zkoušek, v kterých jsou použita pouze dvě nebo jedno ředění, je možné pouze, jsou-li předpoklady linearity, rovnoběžnosti nebo stejného průsečíku prověřeny minulou zkušeností.
Po získání dat zkoušky (ale před výpočtem relativní účinnosti každého zkoušeného přípravku) musí být proveden výpočet analýzy rozptylu, která ověřuje splnění předpokladů 4A a 5A (nebo 4B a 5B). K tomuto účelu je rozdělen součet čtverců na dílčí součty, které odpovídají požadavku splnění jednotlivých podmínek. Zbývající součet čtverců odpovídá reziduální chybě, která umožní pomocí skupiny dílčích F-testů hodnotit jednotlivé zdroje variability.
Pokud je ověřena použitelnost metody, je možno vypočítat účinnost každého zkoušeného přípravku v porovnání se standardem a vyjádřit ji buďto jako relativní účinnost, nebo v jednotkách vhodných pro zkoušený přípravek, např. v mezinárodních jednotkách (m.j.) (IU International Units). Z každé skupiny dat zkoušky je možno vypočítat i meze spolehlivosti.
Zkoušky založené na modelu rovnoběžnosti jsou popsány v části 3.2 a na modelu poměru sklonů v části 3.3.
Když není splněna některá z pěti podmínek (1, 2, 3, 4A, 5A nebo 1, 2, 3, 4B, 5B), jsou zde popsané metody nepoužitelné a mělo by se prověřit technické provedení zkoušky.
Analytik by neměl použít jinou transformaci, není-li prokázáno, že nesplnění předpokladů není náhodné, ale že je způsobeno systematickou změnou laboratorních podmínek. V tomto případě by mělo být před použitím nové transformace v rutinním provozu znovu provedeno testování tak, jak je popsáno v části 3.1.1.
Pokud se při provádění rutinních zkoušek pro porovnání podobných materiálů vyskytuje zvýšený počet zkoušek neplatných kvůli nerovnoběžnosti a nelinearitě, je možnou příčinou to, že plán zkoušky dostatečně neodráží danou situaci. Tento nedostatek je často způsoben neschopností určit všechny zdroje variability, které ovlivňují zkoušku. To může způsobit podhodnocení reziduální chyby, což vede k vysokým hodnotám testovací statistiky F-testu.
V jedné zkoušce není vždycky možné uvažovat všechny možné zdroje variability (např. rozdíly mezi dny). V tom případě se intervaly spolehlivosti získané opakováním zkoušky mohou výrazněji lišit a je třeba opatrnosti při používání dílčích intervalů spolehlivosti. K získáni spolehlivějšího odhadu intervalů spolehlivosti se musí provést více nezávislých zkoušek a z těch pak kombinovat jeden odhad účinnosti a jeho interval spolehlivosti (viz část 6).
Pro účely kontroly kvality rutinních zkoušek se doporučuje zaznamenávat hodnoty sklonu regresní přímky a reziduální chyby pro zobrazení v grafu kontroly kvality zkoušek.
- - Výjimečně vysoké hodnoty reziduální chyby mohou poukazovat na technické problémy. To by mělo být prověřeno a pokud došlo k evidentnímu pochybení v průběhu pokusu, musí být zkouška opakována. Neobvykle vysoká reziduální chyba může také indikovat přítomnost odlehlého nebo vychýleného pozorování. Odpověď, která je v průběhu zkoušky podezřelá z důvodu, že neodpovídá průběhu zkoušky, musí být vyřazena. Je-li odlehlá hodnota zjištěna až po zaznamenání naměřených hodnot, ale je možno vystopovat neregulérnosti zkoušky, může být vynechání této hodnoty oprávněné. Libovolné vypouštění naměřených hodnot ze zpracování může ale způsobit vážné zkreslení. Obecně lze pozorování bez obav vyloučit pouze, pokud je test odlehlých pozorování statisticky významný.
- - Někdy se mohou objevit i výjimečně nízké hodnoty reziduální chyby. Ty pak způsobí, že F-hodnota snadno překročí kritickou hodnotu. V této situaci může být oprávněné nahradit reziduální chybu vypočtenou v této zkoušce průměrnou reziduální chybou z historických dat v grafu kontroly kvality zkoušek.
- 3.1.3 Výpočty a omezení
Z pohledu obecných principů optimálního plánování zkoušek se obvykle kladou tri požadavky, které zjednodušují výpočet a zvyšují přesnost výsledků.
- a) Každý přípravek ve zkoušce musí být testován na stejném počtu ředění;
- b) V modelu rovnoběžnosti musí být podíl sousedních dávek konstantní pro všechna ošetření ve zkoušce; v modelu poměru sklonů musí být vzdálenost mezi sousedními dávkami konstantní pro všechna ošetření.
- c) Pro každé ošetření musí být použit stejný počet pokusných jednotek.
Pokud je použit plán, splňující tato omezení, zjednoduší se algoritmus výpočtu - příslušné vzorce jsou v části 3.2 a 3.3. Doporučuje se však využití programů vyvinutých speciálně pro tyto účely. Existuje mnoho programů, které umí jednoduše pracovat se všemi plány zkoušek obsažených v tomto textu. Ne všechny programy používají identické algoritmy, ale měly by poskytovat stejné výsledky.
Plán zkoušky, který nesplňuje výše zmíněné požadavky, je také použitelný, ale vzorce potřebné pro výpočet jsou příliš komplikované pro prezentaci v tomto textu. Jejich krátký popis je zmíněn v části 7.1. Mohou být použity pro zjednodušený plán zkoušky. Pak poskytují stejné výsledky jako zjednodušené algoritmy.
Vzorce pro zjednodušený plán zkoušek popsané v tomto textu mohou být použity např. pro vytvoření vlastních programů v tabulkových kalkulátorech. Příklady v části 5 pak mohou být použity pro ověření, zda vytvořený program poskytuje správné výsledky.
- 3.2 Model rovnoběžnosti
- 3.2.1 Úvod
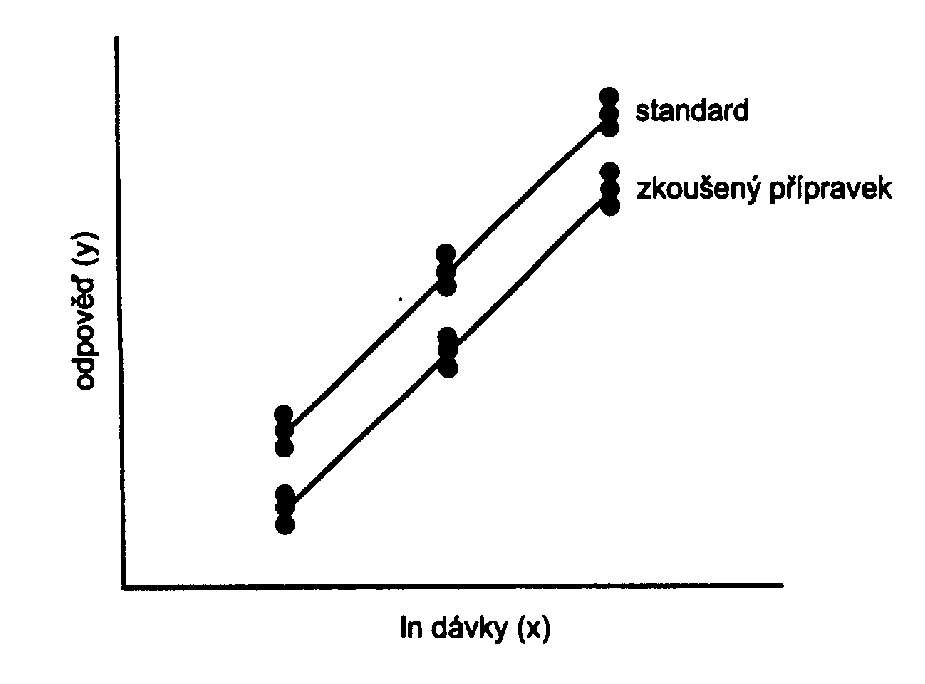
Model rovnoběžnosti je zobrazen na obrázku 3.2.1-1. Na horizontální ose jsou vyneseny hodnoty logaritmu dávky (vlevo nejnižší a vpravo nejvyšší koncentrace). Na svislé ose jsou zobrazeny hodnoty příslušných odpovědí. Jednotlivé odpovědi jsou pro každou koncentraci zobrazeny pomocí černých bodů. Zobrazené dvě přímky představují vypočtenou lineární závislost odpovědi na dávce pro zkoušený a referenční přípravek.
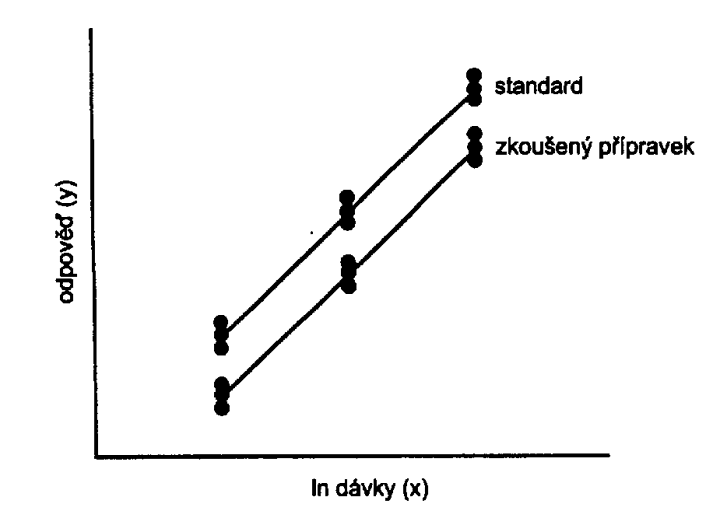
Obr. 3.2.1-I Model rovnoběžnosti pro zkoušku 3 + 3
- Poznámka: V této stati je používán přirozený logaritmus (ln nebo loge). Kdekoliv je použito slovo „antilogaritmus“ nebo „odlogaritmování“, je tím míněna funkce ex. Může být ale použit i „Birggův“ neboli dekadický logaritmus (log nebo log10), odpovídající antilogaritmus je 10x.
Pro uspokojivě dobrý plán zkoušky je nutné, aby předpokládaná účinnost byla blízko skutečné účinnosti. Na základě předpokládané a stanovené účinnosti referenčního přípravku jsou připravena navzájem odpovídající ředění, tj. jsou připravena ředění standardu a zkoušeného přípravku tak, aby dávala stejnou odpověď. Pokud není k dispozici informace o předpokládané účinnosti, musí se provést předběžná zkouška v širokém rozsahu dávek, aby se stanovil obor, kde je závislost lineární.
Čím přesněji aproximuje předpokládaná účinnost neznámého přípravku jeho skutečnou hodnotu, tím blíže jsou obě přímky; srovnatelné dávky by měly dávat i srovnatelnou odpověď. Vodorovná vzdálenost přímek představuje odchylku „skutečné“ účinnosti od předpokládané. Čím větší je vzdálenost mezi oběma přímkami, tím horší je odhad původní předpokládané účinnosti zkoušeného přípravku. Pokud je přímka neznámého přípravku vpravo od přímky standardu, je předpokládaná účinnost nadhodnocena a výpočtem byla získána nižší hodnota odhadované účinnosti, než se předpokládalo. Podobně, jestliže je přímka zkoušeného přípravku vlevo od přímky standardu, je předpokládaná účinnost podhodnocena a výpočet poskytne vyšší odhadovanou účinnost, než je předpokládaná.
- 3.2.1 Úvod
- 3.2.2 Plány zkoušky
- Pro optimalizaci plánu zkoušky jsou užitečné následující úvahy:
- 1) poměr mezi sklonem regresní přímky a reziduální chybou by měl být pokud možno co největší,
- 2) rozsah dávek by měl být pokud možno co největší,
- 3) regresní přímky by měly být pokud možno co nejblíže, tj. předpokládaná účinnost by měla být dobrým odhadem skutečné účinnosti.
Přiřazení pokusných jednotek (zvířat, zkumavek apod.) jednotlivým ošetřením může být provedeno různým způsobem.
- 3.2.2.1 Úplné znáhodnění
Pokud je soubor pokusných jednotek (zvířat, zkumavek apod.) dostatečně homogenní a pokud nelze předem nalézt části souboru s menší variabilitou odpovědí, může být ošetření jednotlivým pokusným jednotkám přiřazeno náhodně.
Když jsou podskupiny jednotek homogennější než celek, např. vlivem tělesného stavu nebo pokusného dne, může být přesnost zkoušky zvýšena zavedením dalších omezení v pokusném plánu. Pečlivé vyvážení plánu s ohledem na tyto okolnosti zajistí eliminaci vedlejších zdrojů varia-bility.
- 3.2.2.2 Náhodné bloky
Pomocí tohoto plánu se mohou vyloučit známé zdroje variability, jako např. rozdíl mezi jednotlivými vrhy pokusných zvířat nebo rozdíl mezi jednotlivými Petriho miskami v difuzních mi-krobiologických zkouškách. Tento plán vyžaduje, aby počty ošetření v jednotlivých blocích (vrzích, Petriho miskách) byly stejné a tak velké, aby jednotlivé bloky mohly zahrnout všechna ošetření. To je ilustrováno v části 5.1.3. Může být použit i znáhodněný plán s opakováním. Algoritmus pro získání náhodných permutací je popsán v části 8.5.
- 3.2.2.3 Latinské čtverce
Tento plán zkoušky je vhodný, ovlivňují-li odpověď dva různé rušivé vlivy nabývající k různých úrovní. Např. mikrobiologické stanovení účinnosti antibiotik se provádí na destičce rozdělené do k × k polí tak, že každé z k ošetření je právě jednou v každém sloupci a v každém řádku destičky. Tento plán pokusu je použitelný při stejném počtu sloupců, řádků i ošetření. Výsledky jsou zaznamenávány do tabulky k × k, nazývané latinský čtverec. Variabilita odpovědi způsobená rozdíly v poloze ošetření na destičce (mezi k sloupci a k řádky) je rovnoměrně rozdělena a tím je tedy snížena chyba. V části 5.1.2 je uveden příklad latinských čtverců. Algoritmus pro vytvoření latinských čtverců je v části 8.6.
- 3.2.2.4 Křížová zkouška
Tento plán je užitečný, je-li možné pokus rozdělit do bloků, z nichž každý obsahuje pouze dvě ošetření, např. tvoří-li blok jedna pokusná jednotka ošetřená dvakrát při různých podnětech. Tento plán pokusu sleduje zvýšení přesnosti omezením vlivu rozdílu mezi pokusnými jednotkami tím, že vyvažuje efekt rozdílu odpovědí na oba podněty. Pokus, ve kterém se testují dvě dávky standardu proti dvěma dávkám přípravku, se nazývá dvoudávkový křížový pokus a podobně pro test se třemi dávkami obou podnětů se používá název třídávkový křížový pokus. Pokus je rozdělen do dvou částí provedených ve vhodných časových intervalech. Pokusné jednotky jsou rozděleny do čtyř (případně šesti) skupin a ošetřeny nejprve jednou ze čtyř (šesti) dávek. Později jsou tytéž jednotky ošetřeny tak, že ty jednotky, které byly ošetřeny menší dávkou, se ošetří dávkou větší a naopak. U jednotlivých pokusných jednotek se též zamění aplikace standardu za přípravek a naopak. Rozložení dávek je zobrazeno v tabulce 3.2.2-I. Příklad použití je možno nalézt v části 5.1.5.
Tab. 3.2.2-I Uspořádání dávek v křížovém pokusu
5.3 Skupina Čas I Čas II 1 S1 T2 2 S2 T1 3 T1 S2 4 T2 S1
- Pro optimalizaci plánu zkoušky jsou užitečné následující úvahy:
- 3.2.3 Analýza rozptylu
V této části jsou uvedeny vzorce, které je potřeba použít při výpočtu analýzy rozptylu. K jejich pochopení pomohou příklady zpracované v části 5.1. K pochopení vzorců slouží i slovníček použitých symbolů (část 9).
Vzorce jsou vhodné pro symetrické zkoušky, ve kterých je porovnáván jeden nebo více zkoušených přípravků (T, U atd.) se standardem (S). Je nutno zdůraznit, že tyto vzorce jsou použitelné pouze při ekvidistantních dávkách podnětů, stejném počtu ošetření pro všechny přípravky a stejném počtu pozorování u všech ošetření.
Bez ohledu na některé úpravy chybového členu je základ analýzy výsledků zkoušek stejný pro plány s úplným znáhodněním, náhodnými bloky a latinskými čtverci. Vzorce pro vyhodnocení křížových pokusů nelze plně schematizovat, analýza jednoho takovéhoto pokusu je obsažena v příkladě 5.1.5.
Vezmou-li se v úvahu body diskutované v části 3.1 a v případě potřeby se transformují odpovědi, mohou se hodnoty y sečíst pro každé ošetření a každý přípravek, jak je to patrné v tabulce 3.2.3-I. Dále by měl být vypočten lineární kontrast odpovídající sklonu závislosti odpovědi na logaritmu dávky. V tabulce 3.2.3-II jsou další tři vzorce, potřebné pro výpočet analýzy rozptylu.
Celková variabilita odpovědí, kterou způsobují různá ošetření, se rozkládá na složky uvedené v tabulce 3.2.3-III. Součty čtverců se vypočtou z hodnot v tabulkách 3.2.3-I a 3.2.3-II. Součet čtverců pro test nelinearity je možno počítat pouze, pokud jsou ve zkoušce pro každý přípravek alespoň tři dávky.
Reziduální chyba zkoušky se získá odečtením složek variability tvořených modelem od celkové variability odpovědi (tabulka 3.2.3-IV). Symbol ӯ je používán pro průměrnou odpověď v celé zkoušce. Pro latinské čtverce je počet opakovaných odpovědí (n) stejný jako počet řádků, sloupců a ošetření (dh).
Nyní se dokončí analýza rozptylu. Průměrné čtverce se vypočtou vydělením součtu čtverců jejich stupni volnosti. Tyto čtverce testovaných veličin se vydělí reziduální chybou (s2) a tak získané testovací charakteristiky se porovnají s odpovídajícími hodnotami tabulky 8.1 nebo se použije vhodný počítačový program.
- 3.2.4 Test validity
- Výsledky zkoušky se pokládají za „statisticky validní“ při těchto výsledcích:
- 1) Lineární složka variability (směrnice regresní přímky) je významná, tj. vypočtená pravděpodobnost je menší než 0,05. Není li tato podmínka splněna, není možno vypočíst 95% meze spolehlivosti.
- 2) Nerovnoběžnost není statisticky významná, tj. vypočtená pravděpodobnost není menší než 0,05. To indikuje, že je splněna podmínka 5A části 3.1.
- 3) Nelineární složky variability nejsou statisticky významné, tj. vypočtená pravděpodobnost není menší než 0,05. To indikuje, že je splněna podmínka 4A části 3.1.
Statisticky významné odchylky od předpokladu rovnoběžnosti ve vícenásobných zkouškách mohou být způsobeny tím, že je do plánu zkoušky zahrnut přípravek, který má jiný sklon lineární závislosti odpovědi na logaritmu dávky než ostatní zkoušené přípravky. Místo odmítnutí této zkoušky jako chybné se mohou odstranit všechny údaje o tomto přípravku a zopakovat výpočet pro zbylé přípravky.
Pokud se prokáže statistická validita dat, mohou být dále popsaným způsobem vypočteny účinnosti a meze spolehlivosti.
- Výsledky zkoušky se pokládají za „statisticky validní“ při těchto výsledcích:
- 3.2.5 Odhad účinnosti a její meze spolehlivosti
- Jestliže je I rozdíl logaritmů sousedních dávek každého přípravku, pak společný sklon (b) všech d-dávkových zkoušek je:
- a logaritmus relativní účinnosti zkoušeného přípravku (např. T) pak je:
- Vypočtená účinnost je odhadem „skutečné účinnosti“ zkoušeného přípravku. Interval spolehlivosti (který s 95% pravděpodobností obsahuje skutečnou hodnotu účinnosti) se vypočte jako antilogaritmus výrazu:
Hodnoty t je možno získat z tabulky 8.2 pro p = 0,05 a počet stupňů volnosti rovný stupňům volnosti reziduální chyby. Odhadovanou účinnost (RT) a jí odpovídající meze spolehlivosti se získají odlogaritmováním získaných hodnot a následným vynásobením hodnotou AT. Nemají-li základní roztoky přesně danou účinnost podle referenční a předpokládané účinnosti, je nutno použít korekční faktor (viz příklady 5.1.2 a 5.1.3).
Tab. 3.2.3-I Vzorce pro zkoušky model rovnoběžnosti s d dávkami pro každý přípravek
5.3 Standard (S) 1. zkoušený přípravek (T) 2. zkoušený přípravek
(U atd.)průměrná odpověď, nej-
nižší dávkaS1 T1 U1 průměrná odpověď, druhá
dávkaS2 T2 U2 ... ... ... ... průměrná odpověď, nej-
vyšší dávkaSd Td Ud celkem
pro přípravkyPS = S1 + S2 +... + Sd PS = T1 + T2 +... + Td PU = ...atd. lineární kontrast LU = ...atd. Tab. 3.2.3-II Další vzorce pro výpočet analýzy rozptylu
5.3 Tab. 3.2.3-III Vzorce pro výpočet součtu čtverců a stupňů volnosti
5.3 Zdroj variability Stupně volnosti (f) Součet čtverců přípravek h - 1 SSpříp = Hp(PS2 + PT2 +...) - K lineární regrese 1 nerovnoběžnost h - 1 SSrovnob = HL (LS2 + LT2 + ...) - SSreg nelinearita(*) h(d - 2) SSlin = SSošetř - SSpříp - SSreg - SSrovnob Ošetření hd - 1 SSošetř = n(S12 + ... + Sd2 + T12 + Td2) - K - Jestliže je I rozdíl logaritmů sousedních dávek každého přípravku, pak společný sklon (b) všech d-dávkových zkoušek je:
- (*) nelze počítat pro dvoudávkové zkoušky
- (*) není počítán pro úplně znáhodněný plán
- (**) počítá se pouze pro latinské čtverce
- (***) závisí na typu plánu zkoušky
Tab. 3.2.3-IV Odhad reziduální chyby
5.3 Zdroj variability Stupně volnosti (f) Součet čtverců bloky (řádky) (*) n - 1 SSblok = h (R12 + ... + Rn2) - K sloupce (**) n - 1 SSsl = hd(C12 + ...+ Cn2) - K reziduální chyba (***) úplné
znáhodněníhd(n - 1) SSres = SScelk - SSošetř náhodné bloky (hd - 1)(n - 1) SSres = SScelk - SSošetř - SSblok latinské čtverce (hd - 2)(n - 1) SSres = SScelk - SSošetř - SSblok - SSsl celkem nhd - 1 SScelk = Σ(y-ӯ)2 - 1 Úvod
- 3.2.6 Chybějící hodnoty
Ve vyvážených zkouškách se může přihodit, že v souvislosti s ošetřením dojde ke ztrátě jedné nebo více odpovědí, např. tak, že některá zvířata uhynou. Pokud lze předpokládat, že selhání nikterak nesouvisejí se složením podávaných přípravků, je možno použít úplnou statistickou analýzu, ale vzorce pro její výpočet jsou mnohem složitější a jsou pouze krátce zmíněny v pasáži o obecném lineárním modelu (viz část 7.1). Nicméně pokud je prokazatelné, že výskyt chybějící hodnoty nijak nesouvisí s přidělením pokusných jednotek do jednotlivých skupin, může být zachována jednoduchost vyhodnocení vyváženého plánu zkoušky tak, že se nahradí chybějící hodnota hodnotou vypočtenou na základě ostatních pozorovaných hodnot. Ztráta informace se pak vezme v úvahu zmenšením počtu stupňů volnosti celkového a součtu čtverců o jeden a použitím vzorce pro výpočet chybějící hodnoty (viz níže). Je třeba si uvědomovat, že tato metoda je pouze přibližná a že by měla být dána přednost přesným metodám.
Pokud chybí více než jedno pozorování, může se použít stejný vzorec. Postup je takový, že se hrubě odhadnou všechny chybějící hodnoty kromě jedné, která se vypočte podle uvedeného vzorce ze všech ostatních hodnot, včetně těch hrubě odhadnutých. Vypočtená hodnota se vezme za pozorovanou a pokračuje se stejným postupem pro všechny další chybějící hodnoty. Po vypočtení všech chybějících hodnot se tímto postupem provede cyklus znovu od začátku, přičemž se místo hrubých odhadů použijí posledně vypočtené hodnoty pro všechny chybějící odpovědi. To vše se opakuje několikrát, až se získají ve dvou po sobě následujících cyklech stejné hodnoty. Konvergence tohoto postupu je obvykle rychlá.
Pokud je počet nahrazovaných hodnot relativně malý v porovnání s celkovým rozsahem zkoušky (menší než 5 %), je použitá aproximace chybějících hodnot a redukce stupňů volnosti o počet chybějících hodnot obvykle uspokojivá. Nicméně výsledky by se měly interpretovat velmi opatrně, obzvláště pokud chybějící hodnoty v některém ošetření nebo bloku převažují. Pak by měl biometr uvážit, zda nepůsobily v průběhu zkoušky nějaké další nežádoucí vlivy. Nahrazení chybějících hodnot ve zkoušce bez jejího opakování je vždy choulostivé.
Úplné znáhodnění
- Při úplném znáhodnění se za odhad chybějící hodnoty bere aritmetický průměr všech ostatních odpovědí daného ošetření.
Plán náhodných bloků
- Chybějící hodnota (y') se vypočte podle vzorce:
- kde B' je součet odpovědí v bloku obsahujícím příslušné chybějící pozorování, T' je součet odpovědí při příslušném ošetření a G' součet všech odpovědí ve zkoušce.
Latinské čtverce
- Chybějící hodnota (y') se nahradí podle vzorce:
- kde B' a C' jsou součty odpovědí v řádce a sloupci s chybějícím pozorováním. V tomto případě je k = n.
Dvoudávková křížová zkouška
- Vyskytne-li se chybějící pozorování v dvoudávkové křížové zkoušce, je důležité konzultovat situaci se statistikem, protože vyhodnocení závisí na konkrétní kombinaci ošetření.
- 3.3 Model poměru sklonů
- 3.3.1 Úvod
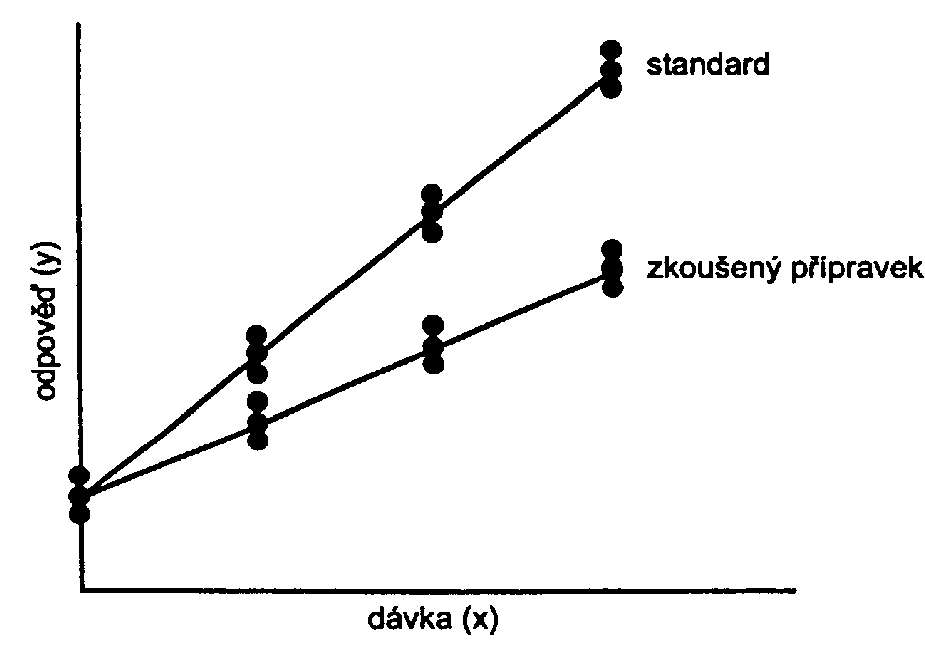
Tento model je vhodný např. pro některé mikrobiologické zkoušky, v nichž je nezávisle proměnnou koncentrace růstového faktoru půdy. Model poměru sklonů, graficky zobrazen na obrázku 3.3.1-I.
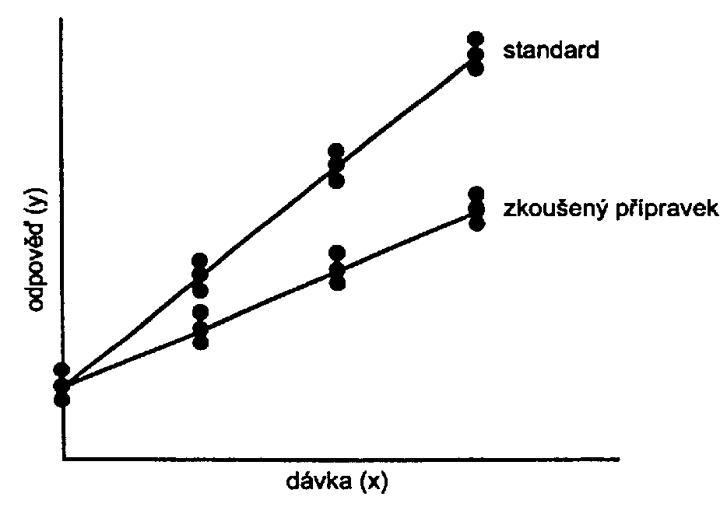
Obr. 3.3.1-I Model poměru sklonů zkoušky 2 × 3 + 1
Dávka s nulovou koncentrací je na vodorovné ose zobrazena vlevo a dávky s nejvyššími koncentracemi vpravo. Odpověď je zobrazena na vertikální ose. Odpovědi na tyto dávky jsou v grafu zobrazeny pomocí černých bodů. Dvě zobrazené přímky představují vypočtenou lineární závislost referenčního a zkoušeného přípravku na dávce za předpokladu, že se protínají v nulové dávce. Na rozdíl od modelu rovnoběžnosti nejsou dávky transformovány logaritmem.
Stejně jako ve zkouškách založených na modelu rovnoběžnosti má být předpokládaná účinnost blízká skutečné hodnotě účinnosti a mají být použita (pokud je to možné) stejně účinná ředění zkoušeného a referenčního přípravku. Čím blíže je předpokládaná účinnost skutečné hodnotě, tím blíže budou i obě přímky. Poměr sklonů představuje „skutečnou“ účinnost zkoušeného přípravku vztaženou k předpokládané účinnosti. Je-li sklon zkoušeného přípravku strmější než sklon standardu, je účinnost podhodnocena a výpočet naznačuje, že odhadovaná účinnost je větší než předpokládaná. Podobně, pokud je sklon zkoušeného přípravku mírnější než sklon standardu, je účinnost nadhodnocena a výpočet naznačuje, že odhadovaná účinnost je menší než předpokládaná.
Při přípravě zkoušky by mělo být ověřeno, zda všechny odpovědi splňují podmínky 1, 2 a 3 z části 3.1. V rámci rutinního zpracování analýzy rozptylu, které je popsáno v části 3.3.3, by mělo být ověřeno splnění podmínek 4B a 5B.
- 3.3.2 Plán zkoušky
- Pro použití dále popsaných statistických metod je nutno klást na zkoušku následující omezení:
- a) pro zkoušený a referenční přípravek musí být použit stejný počet ekvidistantních ředění,
- b) je možno testovat i zvláštní skupinu pokusných jednotek, které nemají žádné ošetření (nulová dávka),
- c) pro každé ošetření musí být použit stejný počet pokusných jednotek.
Jak již bylo konstatováno v části 3.1.3, nemusí pokusné plány splňovat tato omezení, pak ale nejsou použitelné zde popsané jednoduché metody statistické analýzy a je nutno vyhledat radu experta nebo použít vhodný program.
Obvykle bývá dána přednost plánu s dvěma dávkami pro přípravek a se společnou nulovou dávkou (plán (2h + 1)), protože poskytuje vysokou přesnost a možnost ověřit platnost výše zmíněných podmínek. Ne vždy je ale možno předpokládat linearitu až k nulové koncentraci. S malou ztrátou přesnosti je možno použít i plán bez nulové dávky. Pak je ale dávána přednost plánu se třemi dávkami na přípravek „plán (3h)“ před dvoudávkovým plánem. Dávky jsou tedy vytvářeny takto:
- 1) standard je použit v nejvyšší dávce blízké ale nepřesahující oblast, kde je závislost odpovědi na dávce ještě lineární,
- 2) další dávky jsou rovnoměrně rozloženy mezi touto hodnotou a nulovou dávkou,
- 3) pro zkoušený přípravek jsou použity dávky založené na předpokládané účinnosti materiálu.
Podobně jako v části 3.2.2. je možno použít plány s úplným znáhodněním, náhodnými bloky nebo latinskými čtverci. Použití kteréhokoliv z těchto plánů vyžaduje podobnou úpravu postupu pro odhad reziduálního součtu čtverců jako u modelu rovnoběžnosti. Dále je popsána analýza zkoušky jednoho nebo více neznámých přípravků v porovnání se standardem.
- Pro použití dále popsaných statistických metod je nutno klást na zkoušku následující omezení:
- 3.3.3 Analýza rozptylu
- 3.3.3.1 Plán (hd + 1)
Nejprve je nutno ověřit odpovědi, jak je to popsáno v části 3.1, a pokud je to nutné, vhodně je transformovat. Dále se vypočtou průměrné odpovědi pro jednotlivé dávky a přípravky, jako je uvedeno v tabulce 3.3.3.1-I, a průměrná odpověď na nulovou dávku (B).
Podle tabulek 3.3.3.1-I až 3.3.3.1-III se pro analýzu rozptylu vypočte součet čtverců. Součet čtverců pro test nelinearity je možno vypočíst pouze pokud zkouška obsahuje alespoň tři dávky pro každý přípravek. Reziduální chyba se získá odečtením zdrojů variability příslušného plánu od celkové variability (viz 3.3.3.1-IV).
Analýza rozptylu se dokončí vydělením příslušných součtů čtverců jejich stupni volnosti, čímž se získají průměrné čtverce. Ty se pak vydělí reziduálním rozptylem (s2). Získané hodnoty testovací statistiky F se porovnají s kritickými hodnotami z tabulky 8.1 nebo vhodným počítačovým programem.
- 3.3.3.2 Plán (hd)
Vzorce jsou až na drobné rozdíly stejné jako v případě plánu (hd +1).
- • Veličina B se ve vzorcích nevyskytuje.
- • SSnul není obsažena ve vzorcích pro analýzu rozptylu.
- • Počet stupňů volnosti pro ošetření je hd - 1.
- • Počet stupňů volnosti reziduální chyby a celkový rozptyl je počítán stejně jako v modelu rovnoběžnosti (viz tabulka 3.2.3-IV).
Validita zkoušky, účinnost a interval spolehlivosti jsou popsány v části 3.3.4 a 3.3.5.
- 3.3.3.1 Plán (hd + 1)
- 3.3.4 Test validity
- Zkouška je „statisticky validní“, pokud jsou získány následující výsledky analýzy rozptylu:
- 1) kontrast nulové dávky zkoušky s plánem (2h + 1) nesmí být statisticky významný, tj. vypočtená pravděpodobnost nesmí být menší než 0,05. To indikuje, že odpověď na nulovou dávku se statisticky významně neliší od společného průsečíku přímek a předpoklad lineární závislosti platí až do nuly,
- 2) kontrast průsečíků není statisticky významný, tj. vypočtená pravděpodobnost nesmí být menší než 0,05. To naznačuje splnění podmínky 5B z části 3.1,
- 3) ve zkouškách s alespoň třemi dávkami na přípravek není statisticky významný kontrast nelinearity, tj. vypočtená pravděpodobnost nesmí být menší než 0,05. To indikuje splnění podmínky 5B z části 3.1.
Statisticky významný kontrast nulové dávky indikuje, že hypotéza linearity neplatí v okolí nuly. Pokud je pro tento typ zkoušky takovýto výsledek spíše systematický než výjimečný, je vhodnější použití (hd) plánu. V tomto případě nemusí být požadována odpověď na nulovou dávku.
Prokáží-li příslušné testy validitu zkoušky, může být vypočtena účinnost a její meze spolehlivosti postupem popsaným v části 3.3.5.
Tab. 3.3.3.1-I Vzorce pro model sklonů pro plán (2h + 1)
5.3 Standard (S) 1. zkoušený přípravek T 2. zkoušený
přípravek U, atd.průměrná odpověď,
nejnižší dávkaS1 T1 U1 průměrná odpověď,
druhá dávkaS2 T2 U2 ... ... ... ... průměrná odpověď,
nejvyšší dávkaSd Td Ud celkem pro přípravky PS = S1 + S2 +... + Sd PT = T1 + T2 + ... + Td PU = ...atd. lineární kontrast LS = 1S1 + 2S2 + ... + dSd LT = 1T1 + 2T2 + ... + dTd LV = ...atd. průsečík aS = (4d + 2)PS - 6LS aT = (4d + 2)PT - 6LT aU = ...atd. sklon bS = 2LS - (d + 1)PS bT = 2LT - (d + 1)PT bU = ...atd. ošetření GS = S12 + ... + Sd2 GT = T12 + ... + Td2 GU = ...atd. nelinearita* JU = ...atd. - Zkouška je „statisticky validní“, pokud jsou získány následující výsledky analýzy rozptylu:
- * Nelze počítat pro dvoudávkové zkoušky.
- (*) Nelze počítat pro dvoudávkové zkoušky.
- (*) Není počítán pro úplně znáhodněný plán.
- (**) Počítá se pouze pro latinské čtverce.
- (***) Závisí na typu plánu zkoušky.
Tab. 3.3.3.1-II Další vzorce pro výpočet analýzy rozptylu
5.3 Tab. 3.3.3.1-III Vzorce pro výpočet součtů čtverců a stupně volnosti
5.3 Zdroj variability Stupně volnosti (f) Součet čtverců regrese h SSreg = SSošetř - SSnul - SSpru - SSlin nulová dávka 1 SSnul = HB(B - a)2 průsečík h - 1 SSpru = HL((aS2 + aT2 + ...) - h(d2 - d)2a2) nelinearita (*) h(d - 2) SSlin = n(JS + JT + ...) ošetření hd SSošetř = n(B2 + GS + GT + ...) - K Tab. 3.3.3.1-IV Odhad reziduální chyby
5.3 Zdroj variability Stupně volnosti (f) Součet čtverců bloky (řádky) (*) n - 1 SSblok = hd(R12 + ... + Rn2 - K sloupce (**) n - 1 SSsl = hd(C12 +... + Cn2) - K reziduální chyba (***) úplné
znáhodnění(hd + 1)(n - 1) SSrez = SScelk - SSošetř náhodné bloky hd(n - 1) SSrez = SScelk - SSošetř - SSblok latinské
čtverce(hd-1)(n-1) SSrez = SScelk - SSošetř - SSblok - SSsl celkem nhd + n -1 SScelk = Σ(y - ӯ)2 - 3.3.1 Úvod
- 3.3.5 Odhad účinnosti a její meze spolehlivosti
- 3.3.5.1 Plán (hd + 1)
- Společný průsečík a' se vypočítá podle vzorce:
- Sklon pro standard (podobně i pro ostatní přípravky):
- Relativní účinnost každého přípravku se pak vypočte jako podíl:
Vynásobením relativní účinnosti RT očekávanou účinností AT se dostane odhadovaná účinnost RT(= R´T AT). Jsou-li rozdíly mezi sousedními dávkami referenčního přípravku (IS) a zkoušeného přípravku (IT) různé, je nutno účinnost RT vynásobit podílem IS/IT. Na rozdíl od modelu rovnoběžnosti se při výpočtech v modelu sklonu nepoužívá antilogaritmus.
- Interval spolehlivosti pro R´T se vypočítá:
- V1 a V2 jsou čísla vztahující se k rozptylu a kovarianci čitatele a jmenovatele R´T.
Meze spolehlivosti se vynásobí faktorem AT a pokud je to třeba i IS/IT.
- Společný průsečík a' se vypočítá podle vzorce:
- 3.3.5.2 Plán (hd)
- Vzorce jsou stejné jako v plánu (hd + 1) pouze s následující modifikací:
- a' = a (3.3.5.2-1)
- Vzorce jsou stejné jako v plánu (hd + 1) pouze s následující modifikací:
- 3.3.5.1 Plán (hd + 1)
- 4 Kvantální zkoušky
- 4.1 Úvod
V některých zkouškách je nemožné nebo extrémně náročné měřit působení přípravku na každou pokusnou jednotku na stupnici. Místo toho je pozorován nějaký efekt působení přípravku na pokusné jednotky, jako např. uhynutí nebo hypoglykemický symptom pokusných jednotek. Výsledek pak závisí na počtu jednotek, u kterých se projeví tento efekt. Takové zkoušky se nazývají kvantální nebo „vše nebo nic“.
Situace je velmi podobná kvantitativní zkoušce popsané v části 3.1, ale místo n různých odpovědí v každé ošetřené skupině se získá pouze jediná hodnota, tj. procento jednotek s pozitivní odpovědí. Grafem závislosti tohoto procenta na logaritmu dávky je zpravidla spíše křivka tvaru S než přímka. K odhadu křivky závislosti odpovědi na dávce se používají matematické funkce modelující tuto závislost tvaru S. Nejčastěji je používána kumulativní distribuční funkce normálního rozdělení. Tato funkce má několik teoretických výhod a je snad nejlepší volbou, pokud je odpověď zatížena chybou pokusných jednotek. Pokud odpověď více závisí na růstovém procesu, je vhodnější použití logistické regrese. Rozdíl výsledků obou modelů je ale obvykle velmi malý.
Maximálně věrohodný odhad sklonu a polohy těchto křivek je možno získat pouze iteračními metodami. Je mnoho postupů k dosažení stejných výsledků, ty se ale liší svou efektivitou z pohledu rychlosti konvergence. Jedna z nejrychlejších metod je přímá maximalizace věrohodnostní funkce (viz část 7.1). Ta se dá snadno implementovat do počítačových programů jako standardní postup. Většina z těchto postupů však neposkytuje odhady intervalů spolehlivosti a metody jejich výpočtu jsou na tento text velmi složité. Dále popsaná metoda není nejrychlejší, ale je zvolena jako alternativa pro svoji jednoduchost. Může se použít při provádění zkoušek, ve kterých se porovnává jeden nebo více přípravků se standardem. Musí být ale navíc splněny následující požadavky:
- 1) závislost odpovědi na logaritmu dávky má tvar, který je možno popsat pomocí kumulativní distribuční funkce normálního rozdělení,
- 2) křivky standardu a zkoušeného přípravku jsou rovnoběžné, tj. mají stejný tvar a liší se pouze posunutím,
- 3) teoreticky na extrémně nízkou dávku je odpověď negativní a na extrémně vysokou je naopak vždy pozitivní odpověď.
- 4.2 Probitová metoda
Funkci tvaru S lze převést na lineární tvar, pokud se nahradí odpovědi (tj. podíl pozitivních odpovědí ve skupině) odpovídající hodnotou kumulativní distribuční funkce standardního normálního rozdělení. Tato hodnota se obvykle nazývá „normit“ a nabývá hodnot od -∞ do ∞. Dříve bylo doporučováno přičíst 5 a tato získaná hodnota byla nazývána „probit“. Tato úprava zjednodušila ruční provádění výpočtů tím, že se vyhnula záporným hodnotám. S rozvojem výpočetní techniky ztratila tato potřeba přičítat k normitům 5 praktický význam. Pro dále popsanou metodu tedy bude vhodnější používat název „normitová metoda“. Pojem probitová analýza je široce rozšířen, a proto se v této stati z historických důvodů tento název používá.
Po linearizaci odpovědí by se mohlo k hodnocení použít metody pro model rovnoběžného sklonu, popsané v části 3.2. Není však splněn požadavek na homogenitu rozptylů pro každou dávku. Rozptyl je minimální pro normit = 0 a zvětšuje se vzdalováním normitu od nuly na obě strany. Proto je nutno použít pro odpovědi v prostřední části větší váhy a nižší váhy pro okrajové části číselné osy normitů. Dále je popsána takováto metoda analýzy rozptylu, odhadu účinnosti
- a intervalů spolehlivosti.
Tab. 4.2.1-I První pracovní tabulka
5.3 (1)
Dávka(2)
n(3)
r(4)
x(5)
p(6)
Y(7)
Φ(8)
Z(9)
y(10)
w(11)
wx(12)
wy(13)
wx2(14)
wy2(15)
wxzS . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . Σ= Σ= Σ= Σ= Σ= Σ= T . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . Σ= Σ= Σ= Σ= Σ= Σ= atd. Tab. 4.2.1-II Druhá pracovní tabulka
5.3 (1)
Σw(2)
Σwx(3)
Σwy(4)
Σwx2(5)
Σwy2(6)
Σwxy(7)
Sxx(8)
Sxy(9)
Syy(10)
(11)
ӯ(12)
aS . . . . . . . . . . . . T . . . . . . . . . . . . atd. . . . . . . . . . . . . Σ= Σ= - 4.2.1 Zapisování výsledků
Tabulka 4.2.1-I se používá pro zápis dat do sloupců označených čísly.
(1) Dávka standardu nebo zkoušeného přípravku.
(2) Počet vyšetřených jednotek n pro příslušné ošetření.
(3) Počet jednotek r, které měly pozitivní odpověď na toto ošetření.
(4) Logaritmus x dávky.
(5) Podíl pozitivních odpovědí ve skupině.
- Zde začíná iterační cyklus.
(6) Sloupec Y je při prvním iteračním kroku vyplněn nulami.
(7) Odpovídající hodnoty Φ = Φ(Y) kumulativní distribuční funkce normálního rozložení (viz tabulka 8.4).
- Pro výpočet sloupců (8) až (10) jsou použity vzorce:
Sloupce (11) až (15) se jednoduše vypočtou ze sloupců (4), (9) a (10) jako wx, wy, wx2, wy2 a wxy. Dále se vypočtou pro každý přípravek zvlášť součty Σ sloupců (10) až (15).
- Součty z tabulky 4.2.1-I se přepíší do sloupců (1) až (6) tabulky 4.2.1-II. a 6 dalších sloupců (7) až (12) se vypočte pomocí vzorců:
- Společný sklon b se pak vypočte jako:
- a průsečík a přímek pro referenční a zkoušený přípravek je
Sloupec (6) první pracovní tabulky se teď může nahradit hodnotami Y = a + bx a cyklus tak dlouho opakovat, dokud nebude rozdíl dvou po sobě následujících cyklů dostatečně malý, tj. např. pokud maximální rozdíl Y ve dvou po sobě následujících cyklech nebude menší než 10-8.
- 4.2.2 Testy validity
Před výpočtem účinností a jejich intervalů spolehlivosti je třeba ověřit validitu, tj. linearitu závislosti transformované veličiny y (4.2.1-2) na logaritmu dávky x a rovnoběžnost přímek vyjadřujících tento vztah pro všechny přípravky. Odchylka od linearity pro všechny přípravky podané nejméně ve třech dávkách se vypočte takto: Do tabulky 4.2.1-II se připojí sloupec číslo (13) obsahující hodnoty veličiny:
Součet hodnot ve třináctém sloupci ΧL2 je mírou odchylky od linearity. Zkoušku je třeba zamítnout, když ΧL2 překročí na hladině významnosti 0,05 kritickou hodnotu Χ2 rozdělení s (N - 2h) stupni volnosti. Tato kritická hodnota se najde v tabulce 8.3 nebo se vypočte pomocí vhodného počítačového programu. N je počet všech podaných dávek a h je počet všech přípravků zahrnutých do zkoušky. Je-li hodnota významná na hladině významnosti 0,05 je nutno zkoušku zamítnout (viz část 4.2.4).
- Pokud výše zmíněný test neindikuje významnou odchylku od linearity, je třeba dále na hladině významnosti 0,05 otestovat rovnoběžnost. K tomu se použijí kritéria ΧR2 s h - 1 stupni volnosti:
- (součet Σ se provede přes všechny přípravky).
Když hodnota ΧR2 překročí příslušnou kritickou hodnotu rozdělení Χ2, pokládá se odchylka od rovnoběžnosti za statisticky významnou. Pokud odchylky od linearity a rovnoběžnosti nejsou statisticky významné, je zkouška validní.
- Pokud výše zmíněný test neindikuje významnou odchylku od linearity, je třeba dále na hladině významnosti 0,05 otestovat rovnoběžnost. K tomu se použijí kritéria ΧR2 s h - 1 stupni volnosti:
- 4.2.3 Odhad účinnosti a její meze spolehlivosti
- Pokud nebyly nalezeny žádné odchylky od předpokladu linearity a rovnoběžnosti, je možno vypočítat logaritmus relativní účinnosti:
- a dále tento výraz odlogaritmovat. Dále se položí t = 1,96 a s = 1. Meze spolehlivosti se pak získají odlogaritmováním výrazu:
- kde
- a
- Pokud nebyly nalezeny žádné odchylky od předpokladu linearity a rovnoběžnosti, je možno vypočítat logaritmus relativní účinnosti:
- 4.2.4 Chybné zkoušky
Je-li test odchylky od linearity, viz část 4.2.2, statisticky významný, měla by se příslušná zkouška zamítnout jako nevyhovující. Někdy může být důvod předpokládat, že k této odchylce přispívají další v průběhu zkoušky nekontrolovatelné nebo nekontrolované vlivy. Pak je možné zkoušku zachovat s mírnou modifikací hodnocení jejích výsledků. Za t se položí kritická hodnota t-rozdělení (p = 0,05) se stejným počtem stupňů volnosti jako v testu linearity (N - 2h) a s se změní tak, že je:
- (tato hodnota bude obvykle větší než 1).
- Testové kritérium pro test rovnoběžnosti je pak podíl
- který má F rozdělení s h - 1 a N - 2h stupni volnosti. Statistická významnost podílu F se otestuje na hladině významnosti 0,05.
- 4.3 Logitová metoda
Jak již bylo řečeno v části 4.1, je někdy vhodnější použít logitovou metodu. Jméno je odvozeno od logitové funkce, která je inverzní k logistickému rozložení. Postup odhadu je podobný, jako byl popsán u probitové metody, pouze s následující modifikací funkcí Φ a Z:
- 4.4 Jiné tvary křivek
Probitová a logitová metoda prakticky vždy postačují pro analýzu kvantálních dat požadovanou v lékopise. Nicméně pokud je zřejmé, že závislost odpovědi na logaritmu dávky má jiný tvar než zmíněné křivky, je možno změnit tvar funkcí Φ a Z. Funkce Z je první derivací funkce Φ. Např. pokud je prokazatelné, že funkce není symetrická, může být vhodným modelem Gompertzovo rozdělení (metoda gompit); v tom případě je
- 4.5 Medián efektivní dávky
U některých typů zkoušek je požadováno získání odhadu mediánu efektivní dávky, což je dávka, na kterou odpoví 50 % jednotek. Probitovou metodu je možno použít i pro stanovení mediánu efektivní dávky (ED50), ale protože není potřeba tuto dávku vyjádřit relativně vzhledem ke standardu, jsou příslušné vzorce mírně odlišné.
Poznámka: Standard by měl být do zkoušky nezávazně též zahrnut, aby bylo možno ověřit validitu zkoušky. Obvykle se zkouška považuje za validní, pokud je vypočtená hodnota ED50 standardu dostatečně blízko jeho předpokládané hodnotě. Co to znamená „dostatečně blízko”, závisí na požadavcích uvedených v jednotlivých článcích.
Tabulky pro odpovědi zkoušeného vzorku a nezávazně i standardu jsou v části 4.2.1. Test linearity je popsán v části 4.2.2. Test rovnoběžnosti není pro tento typ zkoušky nutný. Odhad ED50 zkoušeného přípravku T, podobně i pro ostatní přípravky, se získá podle popisu v části 4.2.3, ale s následující modifikací vzorců 4.2.3-1 a 4.2.3-2:
- a
- 4.1 Úvod
- 5 Příklady
Tato část ilustruje použití výše popsaných vzorců a postupů na pracovních příkladech, které byly vybrány především pro ilustraci statistických metod a výpočtů. Nejsou zamýšleny jako příklad vhodných metod zkoušek, pokud jsou ve speciální části povoleny i jiné metody. Ke zvýšení jejich užitečnosti pro kontrolu přesnosti výpočtů je použit větší počet desetinných míst, než je nezbytné pro hodnocení výsledků zkoušek. Je nutno poznamenat, že existují i jiné ekvivalentní metody výpočtu. Tyto metody by měly vést k úplně stejným výsledkům jako zde publikované metody.
- 5.1 Model rovnoběžnosti
- 5.1.1 Dvoudávková vícenásobná zkouška úplně znáhodněná
Stanovení účinnosti kortikotropinu podkožním podáním potkanům
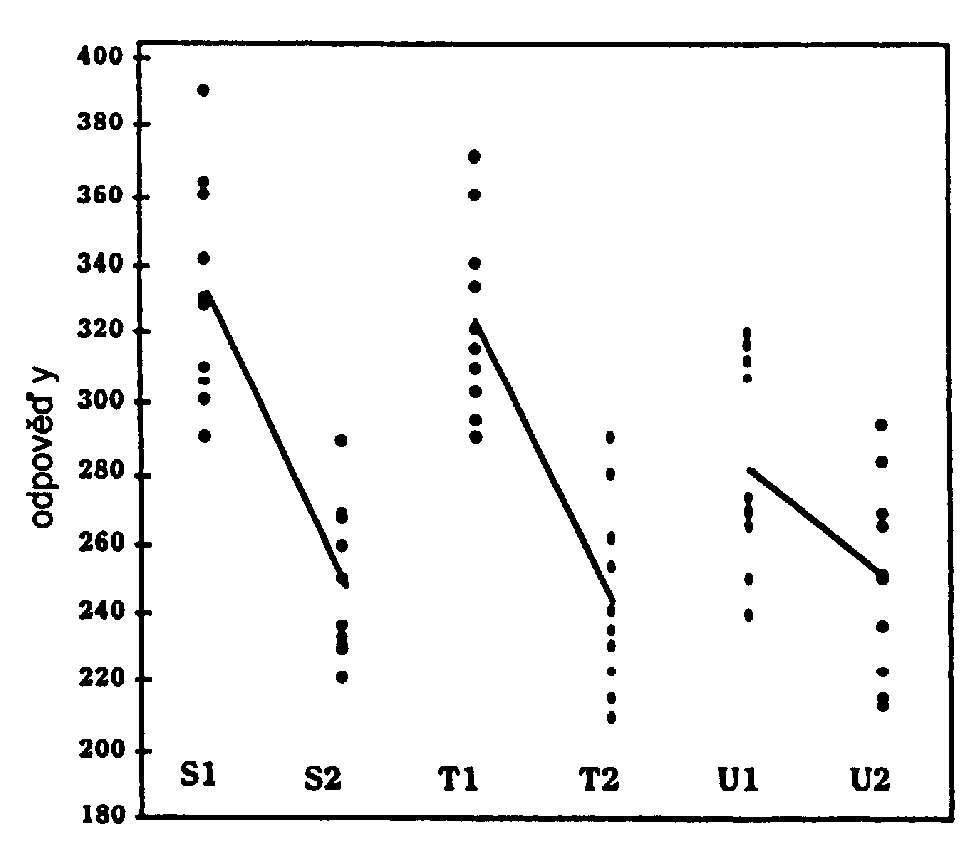
Standard se podával v dávkách 0,25 a 1,0 jednotek na 100 g tělesné hmotnosti. Testovaly se dva přípravky, oba o předpokládané účinnosti 1 jednotka na miligram. Přípravky se tedy podávaly ve stejných dávkách jako standard. Jednotlivé odpovědi a jejich průměry jsou v tabulce 5.1.1-I. Grafická prezentace nevzbuzuje žádné pochybnosti o homogenitě rozptylu a normalitě dat, ale otvírá otázku o platnosti předpokladu rovnoběžnosti u přípravku U.
Tab. 5.1.1-I Odpovědi y množství kyseliny askorbové (mg) ve 100 g nadledvin
5.3 Standard S Přípravek T Přípravek U S1 S2 T1 T2 U1 U2 300 289 310 230 250 236 310 221 290 210 268 213 330 267 360 280 273 283 290 236 341 261 240 269 364 250 321 241 307 251 328 231 370 290 270 294 390 229 303 223 317 223 360 269 334 254 312 250 342 233 295 216 320 216 306 259 315 235 265 265 průměr 332,0 248,4 323,9 244,0 282,2 250,0 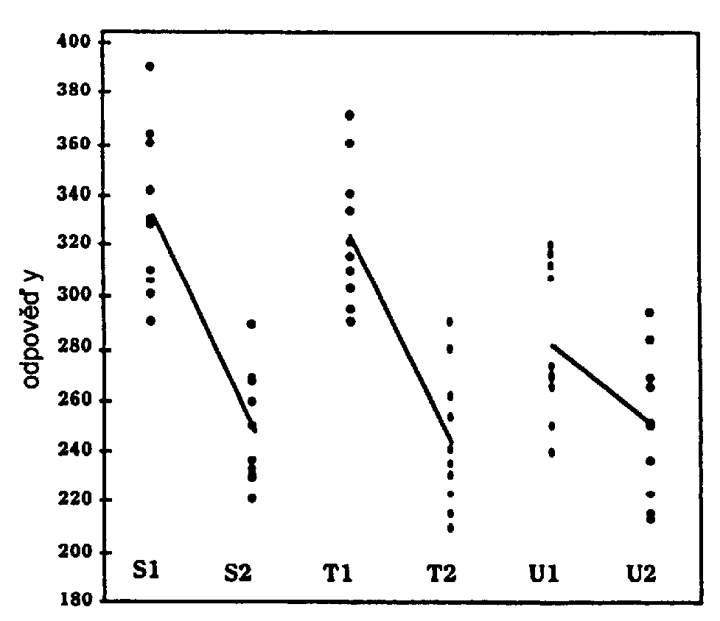
Obr. 5.1.1-I
- Vzorce v tabulce 3.2.3-I a 3.2.3-II vedou k hodnotám:
5.3 PS = 580,4 LS = -41,8 PT = 567,9 LT = -39,95 PU = 532,2 LU = -16,1
Analýza rozptylu se dokončí za pomoci vzorců z tabulek 3.2.3-III a 3.2.3-IV, viz tabulka 5.1.1-II.
Tab. 5.1.1-II Analýza rozptylu
5.3 Zdroj variability Stupně volnosti Součet čtverců Průměrný čtverec F-statistika Pravděpodobnost přípravek
regrese
nerovnoběžnost2 6256,6 3128,3 1 63 830,8 63 830,8 83,38 0,000 2 8218,2 4109,1 5,37 0,007 ošetření 5 78 305,7 reziduální chyba 54 41 340,9 765,57 celkem 59 119 646,6 Analýza potvrdila silnou lineární závislost. Odchylka od předpokladu rovnoběžnosti je také silně významná (p = 0,0075). To se dalo očekávat již z grafické prezentace, kde závislost na dávce není u přípravku U paralelní se závislostí na standardu. Tento přípravek se tedy z analýzy vyloučí a výpočet se zopakuje pouze pro přípravek T a standard S.
Tab. 5.1.1-III Analýza rozptylu bez přípravku U
5.3 Zdroj variability Stupně volnosti Součet čtverců Průměrný čtverec F-statistika Pravděpodobnost přípravek
regrese
nerovnoběžnost1 390,6 390,6 1 66 830,6 66 830,6 90,5 0,000 1 34,2 34,2 0,05 0,831 ošetření 3 67 255,5 reziduální chyba 36 26 587,3 738,54 celkem 39 93 842,8 - Výsledky analýzy bez přípravku U jsou v souladu s požadavky linearity a rovnoběžnosti, může se tedy přistoupit k výpočtu účinnosti. Vzorce z části 3.2.5 dají následující výsledky:
- Pro společný sklon
- logaritmus relativní účinnosti
- a logaritmus mezí spolehlivosti
Po odlogaritmování se získá relativní účinnost 1,11 s 95% intervalem spolehlivosti od 0,82 do 1,51.
Po vynásobení předpokládanou účinností přípravku T se získá účinnost 1,11 jednotky/mg s mezemi spolehlivosti od 0,82 do 1,51 jednotek/mg.
- Vzorce v tabulce 3.2.3-I a 3.2.3-II vedou k hodnotám:
- 5.1.2 Třídávková zkouška s latinskými čtverci
Stanovení účinnosti antibiotik difuzní metodou v pravoúhlých plotnách
Použitý standard má předpokládanou účinnost 4855 m.j./mg, zkoušený přípravek má stanovenou účinnost 5600 m.j./mg. Jako základní ředění bylo rozpuštěno 25,2 mg standardu v 24,5 ml rozpouštědla a 21,4 mg zkoušeného přípravku v 23,95 ml rozpouštědla. Tento základní roztok byl u obou přípravků ředěn 1 : 20 a dále byl použit ředicí poměr 1,5.
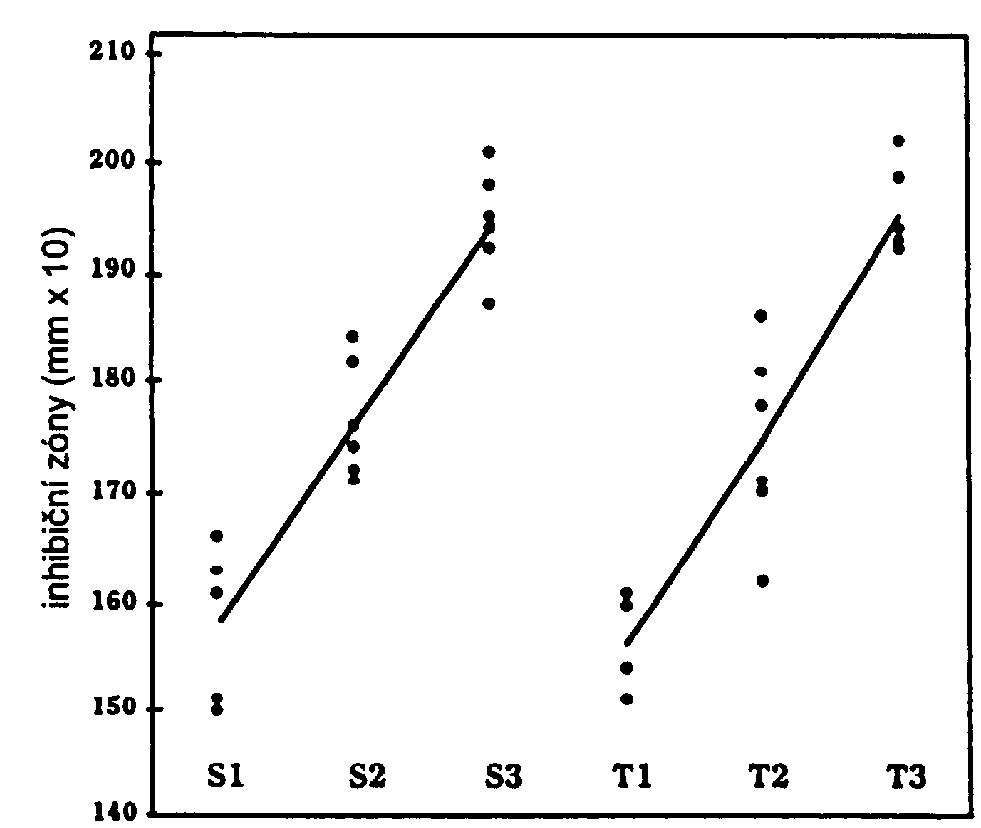
Latinské čtverce byly vytvořeny metodou popsanou v části 8.6, viz. tabulka 5.1.2-I. Odpovědi (inhibiční zóny jsou v mm × 10) jsou uvedeny v tabulce 5.1.2-II. Průměry pro jednotIivá ošetření jsou v tabulce 5.1.2-III. Graficky jsou data zobrazena na obrázku 5.1.2-I, který nezadává důvod pochybovat o splnění požadavků normality a homogenity rozptylů.
Tab. 5.1.2-I Rozložení ošetření na plotně
5.3 1 2 3 4 5 6 1 S1 T1 T2 S3 S2 T3 2 T1 T3 S1 S2 T2 S3 3 T2 S3 S2 S1 T3 T1 4 S3 S2 T3 T1 S1 T2 5 S2 T2 S3 T3 T1 S1 6 T3 S1 T1 T2 S3 S2 Tab. 5.1.2-II Změřené inhibiční zóny v mm × 10
5.3 1 2 3 4 5 6 průměry řádků 1 161 160 178 187 171 194 175,2 = R1 2 151 192 150 172 170 192 171,2 = R2 3 162 195 174 161 193 151 172,7 = R3 4 194 184 199 160 163 171 178,5 = R4 5 176 181 201 202 154 151 177,5 = R5 6 193 166 161 186 198 182 181,0 = R6 průměry
sloupců172,8
= C1179,7
= C2177,2
= C3178,0
= C4174,8
= C5173,5
= C6Tab. 5.1.2-III Průměry
5.3 Standard S Přípravek T S1 S2 S3 T1 T2 T3 průměr 158,67 176,50 194,50 156,17 174,67 195,50 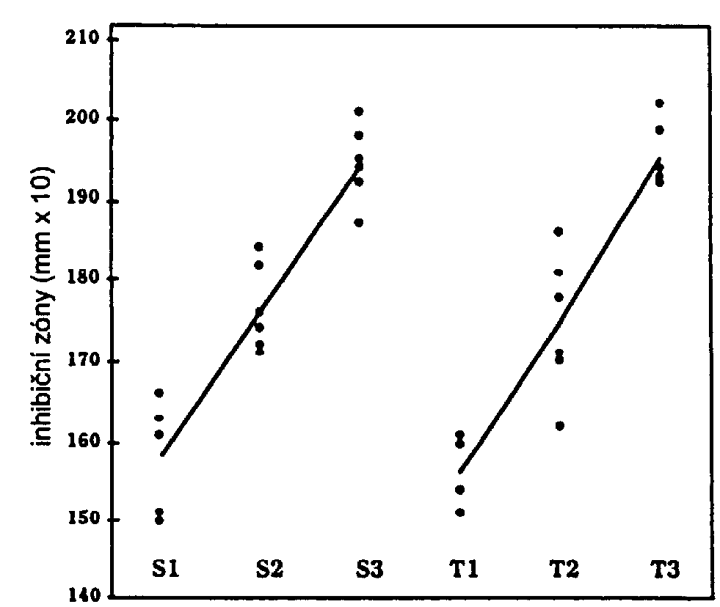
Obr. 5.1.2-I
- Dosazením do vzorců v tabulkách 3.2.3-I a 3.2.3-II se získá:
5.3 PS = 529,667 LS = 35,833 PT = 526,333 LT = 39,333
Pomocí vzorců z tabulek 3.2.3-III a 3.2.3-IV se dokončí výpočet analýzy rozptylu. Výsledky jsou v tabulce 5.2.1-IV.
Tab. 5.1.2-IV
5.3 Zdroj variability Stupně volnosti Součet čtverců Průměrný čtverec F-statistika Pravděpodobnost přípravek 1 11,1111 11,1111 regrese 1 8475,0417 8475,0417 408,1 0,000 nerovnoběžnost 1 18,3750 18,3750 0,885 0,358 nelinearita 2 5,4722 2,7361 0,132 0,877 ošetření 5 8510 řádky 5 412 82,40 3,968 0,012 sloupce 5 218,6667 43,73 2,106 0,107 reziduální chyba 20 415,3333 20,7667 celkem 35 9556 Výsledky této analýzy ukazují, že jsou statisticky významné rozdíly mezi jednotlivými řádky. To poukazuje na zpřesnění výsledků zkoušky při použití latinských čtverců oproti úplnému znáhodnění plánu zkoušky. Vysoká významnost závislosti na dávce a nevýznamnost odchylky od předpokladu linearity a rovnoběžnosti potvrzují, že je možné pro zkoušku vypočítat účinnost.
- Dosazením do vzorců části 3.2.5 se získá:
- společný sklon
- logaritmus relativní účinnosti
- a logaritmus mezí spolehlivosti je:
- společný sklon
Odlogaritmováním se získá relativní účinnost 0,9763 s 95% mezemi spolehlivosti od 0,9112 do 1,0456.
Je nutno použít korekční faktor protože ředění nejsou z pohledu předpokládané účinnosnosti zcela ekvivalentní. Vynásobením korekčním faktorem a předpokládanou účinností 5600 m.j./mg se získá účinnost zkoušeného přípravku 5456 m.j./mg s 95% intervalem spolehlivosti od 5092 do 5843 m.j./mg.
- Dosazením do vzorců v tabulkách 3.2.3-I a 3.2.3-II se získá:
- 5.1.3 Čtyřdávková zkouška s náhodnými bloky
Stanoveni účinnosti antibiotik turbidimetrickou metodou
Tato zkouška je navržena pro zjištění účinnosti v mezinárodních jednotkách na lahvičku. Standard má stanovenou účinnost m.j./mg. Zkoušený přípravek má předpokládanou účinnost 20 000 m.j./lahvičku. Na základě těchto informací bylo následujícím způsobem připraveno základní ředění. 16,7 mg standardu bylo rozpuštěno v 25 ml rozpouštědla a obsah jedné lahvičky zkoušeného přípravku ve 40 ml rozpouštědla. Konečné ředění bylo připraveno nejprve zředěním 1 : 40 a dále použitím ředicího faktoru 1,5. Zkumavky byly umístěny do vodní lázně v uspořádání do náhodných bloků, viz část 8.5. Odpovědi (absorbance) jsou uvedeny v tabulce 5.1.3-I.
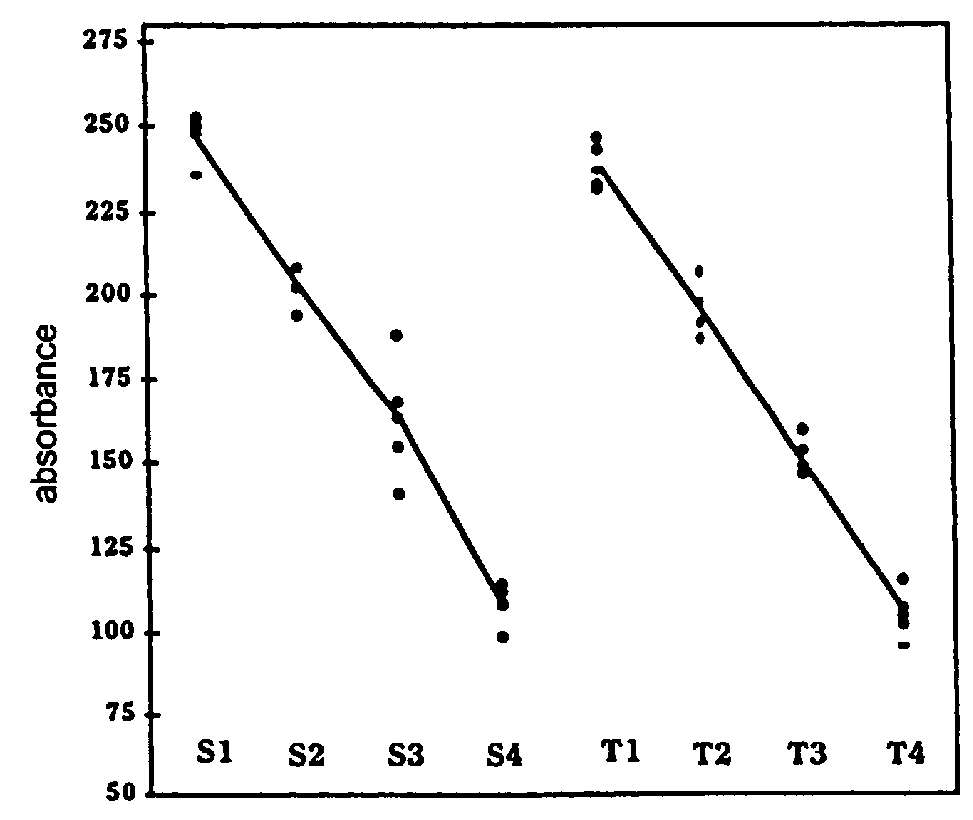
Pohled na obrázek 5.1.3-I nedává důvod pochybovat o platnosti předpokladů normality a homogenity rozptylů zobrazených dat. Směrodatná odchylka S3 je poněkud vyšší, ale není důvod ke zvýšení pozornosti.
Tab. 5.1.3-I Absorbance suspenze (×1000)
5.3 Standard S Přípravek T blok S1 S2 S3 S4 T1 T2 T3 T4 Průměr 1 252 207 168 113 242 206 146 115 181,1 2 249 201 187 107 236 197 153 102 179,0 3 247 193 162 111 246 197 148 104 176,0 4 250 207 155 108 231 191 159 106 175,9 5 235 207 140 98 232 186 146 95 167,4 průměr 246,6 203,0 162,4 107,4 237,4 195,4 150,4 104,4 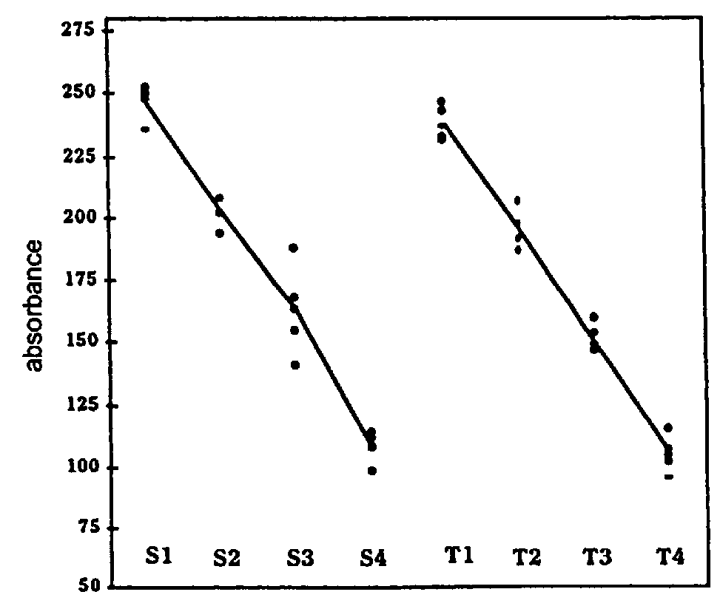
Obr. 5.1.3-I
- Použitím vzorců z tabulky 3.2.3-I a 3.2.3-II se získá:
5.3 PS=719,4 LS = -229,1 PT=687,6 LT = -222
Analýza rozptylu je vypočtena pomocí vzorců z tabulek 3.2.3-III a 3.2.3-IV. Výsledky jsou v tabulce 5.1.3-II.
Tab. 5.1.3-II Analýza rozptylu
5.3 Zdroj variability Stupně volnosti Součet čtverců Průměrný čtverec F-statistika Pravděpodobnost přípravek 1 623,025 623,025 regrese 1 101 745,6 101 745,6 1887,1 0,000 nerovnoběžnost 1 25,205 25,205 0,467 0,500 nelinearita 4 259,14 64,785 1,202 0,332 ošetření 7 102 662 bloky 4 876,75 219,188 4,065 0,010 reziduální chyba 28 1509,65 53,916 celkem 39 105 048,4 Rozdíl mezi bloky je statisticky významný a to indikuje, že použití náhodných bloků pro plán zkoušky zvýšilo přesnost prováděné zkoušky. Vysoká významnost závislosti na dávce a nevýznamnost odchylky od předpokladu linearity a rovnoběžnosti potvrzují, že je možno pro zkoušku vypočíst účinnost.
- Dosazením do vzorců části 3.2.5 se získá:
- společný sklon
- logaritmus účinnosti
- a logaritmus mezí spolehlivosti je:
- společný sklon
Odlogaritmováním se získá relativní účinnost 1,0741 s 95% mezemi spolehlivosti od 1,0291 do 1,1214.
Je nutno použít korekční faktor protože ředění nejsou z pohledu předpokládané účinnosti zcela ekvivalentní. Vynásobením korekčním faktorem a předpokládanou účinností 20 000 m.j./lahvičku se získá účinnost zkoušeného přípravku 19 228 m.j./lahvičku s 95% intervalem spolehlivosti od 18 423 do 20 075 m.j./lahvičku.
- Použitím vzorců z tabulky 3.2.3-I a 3.2.3-II se získá:
- 5.1.4 Pětidávková vícenásobná zkouška s úplně znáhodněným plánem
Zkouška in vitro tří vakcín hepatitidy B v porovnání se standardem
Pro standard a každou vakcínu byly připraveny tři dvojité řady ředění v pěti různých koncentracích. Po několika dalších krocích byla změřena jejich odpověď (absorbance), viz tabulka 5.1.4-I.
Tabulka 5.1.4-I
5.3 Ředění Standard S Přípravek T Přípravek U Přípravek V 1:16 000 0,043 0,045 0,051 0,097 0,097 0,094 0,086 0,071 0,073 0,082 0,082 0,086 1:8000 0,093 0,099 0,082 0,167 0,157 0,178 0,127 0,146 0,133 0,145 0,144 0,173 1:4000 0,159 0,154 0,166 0,327 0,355 0,345 0,277 0,268 0,269 0,318 0,306 0,316 1:2000 0,283 0,295 0,362 0,501 0,665 0,576 0,586 0,489 0,546 0,552 0,551 0,624 1:1000 0,514 0,531 0,545 1,140 1,386 1,051 0,957 0,866 1,045 1,037 1,039 1,068 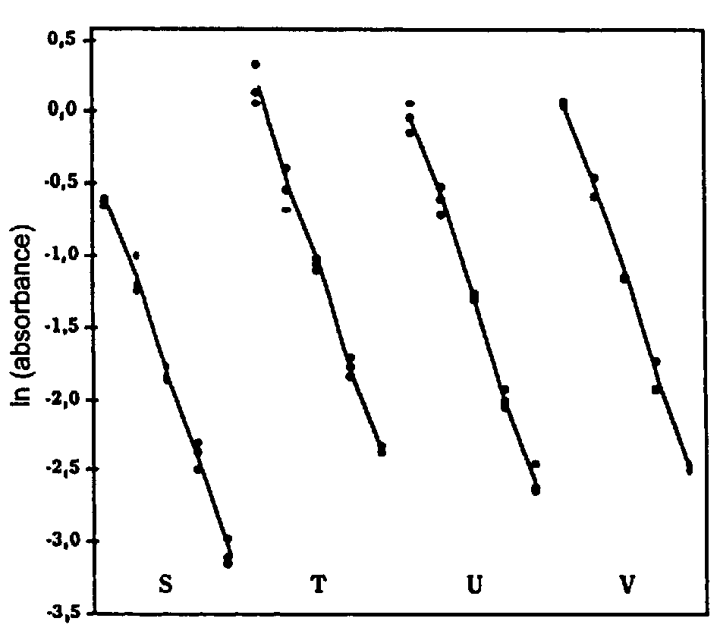
Obr. 5.1.4-I
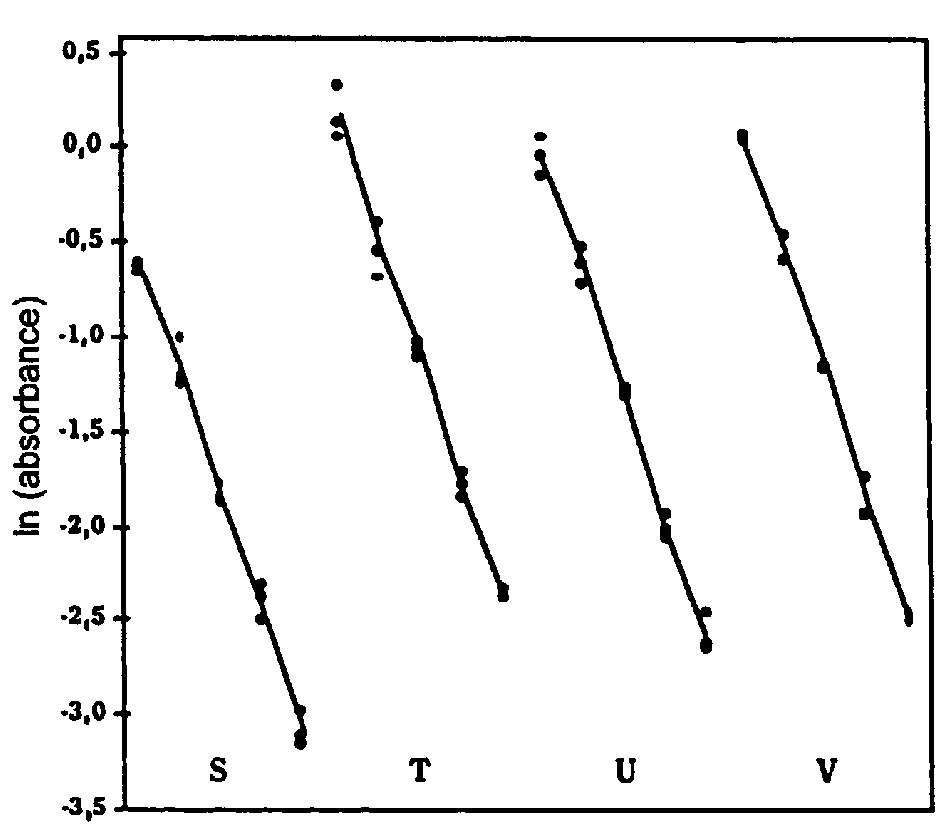
O logaritmu optické denzity je známo, že lineárně závisí na logaritmu dávky. Průměrné odpovědi logaritmu optické denzity na jednotlivé dávky jsou v tabulce 5.1.4-II. Na grafickém zobrazení nejsou patrny žádné anomáIie.
Tabulka 5.1.4.-II
5.3 S1 -3,075 T1 -2,344 U1 -2,572 V1 -2,485 S2 -2,396 T2 -1,789 U2 -2,002 V2 -1,874 S3 -1,835 T3 -1,073 U3 -1,305 V3 -1,161 S4 -1,166 T4 -0,550 U4 -0,618 V4 -0,554 S5 -0,635 T5 0,169 U5 -0,048 V5 0,047 - Dosazením do vzorců v tabulkách 3.2.3-I a 3.2.3-II se získá:
5.3 PS = -9,108 LS = 6,109 PT = -5,586 LT = 6,264 PU = -6,554 LU = 6,431 PV = -6,027 LV = 6,384
Pomocí vzorců z tabulek 3.2.3-III a 3.2.3-IV se dokončí výpočet analýzy rozptylu. Výsledky jsou v tabulce 5.1.4-III.
Tab. 5.1.4-III Analýza rozptylu
- Dosazením do vzorců v tabulkách 3.2.3-I a 3.2.3-II se získá:
- 5.1.1 Dvoudávková vícenásobná zkouška úplně znáhodněná
- 5.1 Model rovnoběžnosti