| Zdroj variability | Stupně volnosti | Součet čtverců | Průměrný čtverec | F-statistika | Pravděpodobnost |
|---|---|---|---|---|---|
| přípravek | 3 | 4,475 | 1,492 | ||
| regrese | 1 | 47,58 | 47,58 | 7126 | 0,000 |
| nerovnoběžnost | 3 | 0,0187 | 0,006 | 0,933 | 0,434 |
| nelinearita | 12 | 0,0742 | 0,006 | 0,926 | 0,531 |
| ošetření | 19 | 52,152 | |||
| reziduální chyba | 40 | 0,267 | 0,0067 | ||
| celkem | 59 | 52,42 |
Vysoká významnost závislosti na dávce a nevýznamnost odchylky od předpokladu linearity a rovnoběžnosti potvrzují, že je možno pro zkoušku vypočítat účinnost.
- Dosazením do vzorců části 3.2.5 se získá:
- společný sklon
- logaritmus relativní účinnosti přípravku T
- a logaritmus mezí spolehlivosti je:
- společný sklon
Odlogaritmováním se získá relativní účinnost 2,171 s 95% mezenu spolehlivosti od 2,027 do 2,327. Všechny vzorky měly předpokládanou účinnost 20 μg proteinu/ml, proto je účinnost přípravku T rovna 43,4 μg proteinu/ml s 95% mezemi spolehlivosti od 40,5 μg do 46,5 μg proteinu /ml.
Stejně se vypočte odhad účinnosti a mezí spolehlivosti zbylých dvou přípravků. Výsledky jsou v tabulce 5.1.4-IV.
Tab. 5.1.4-IV
| Dolní mez | Odhad | Horní mez | |
|---|---|---|---|
| vakcína T | 40,5 | 43,4 | 46,5 |
| vakcína U | 32,9 | 35,2 | 37,6 |
| vakcína V | 36,8 | 39,4 | 42,2 |
- 5.1.5 Dvojitě křížová zkouška
Stanovení účinnosti insulinu na králících podkožním podáním
Standardní přípravek se aplikoval v dávkách 1 a 2 jednotky na mililitr. Na základě předpokládané účinnosti neznámého přípravku (AU = 40 jednotek na mililitr) byly připraveny ekvivalentní dávky přípravku. Jednotliví králíci obdrželi podkožně 0,5 ml odpovídajícího ředění podle plánu v tabulce 5.1.5-I. VýsIedné odpovědi jsou v tabulce 5.1.5-II. Velký rozptyl, který je zřejmě způsoben variabilitou mezi jednotlivými zvířaty, ilustruje užitečnost křížového pokusu.
Tab. 5.1.5-I Uspořádání ošetření
Skupina králíků 1 2 3 4 den I S1 S2 T1 T2 den II T2 T1 S2 S1 Tab. 5.1.5-II Odpovědi y: součty hodnot glukosy v krvi (mg/100 ml) po 1 a 2 1/2 h
Skupina 1 Skupina 2 Skupina 3 Skupina 4 S1 T2 S2 T1 T1 S2 T2 S1 112 104 65 72 105 91 118 144 126 112 116 160 83 67 119 149 62 58 73 72 125 67 42 51 86 63 47 93 56 45 64 107 52 53 88 113 92 84 93 117 110 113 63 71 101 56 73 128 116 91 50 65 66 55 39 87 101 68 55 100 91 68 31 71 průměr 95,6 82,8 69,6 93,3 89,9 66,6 72,4 106,8 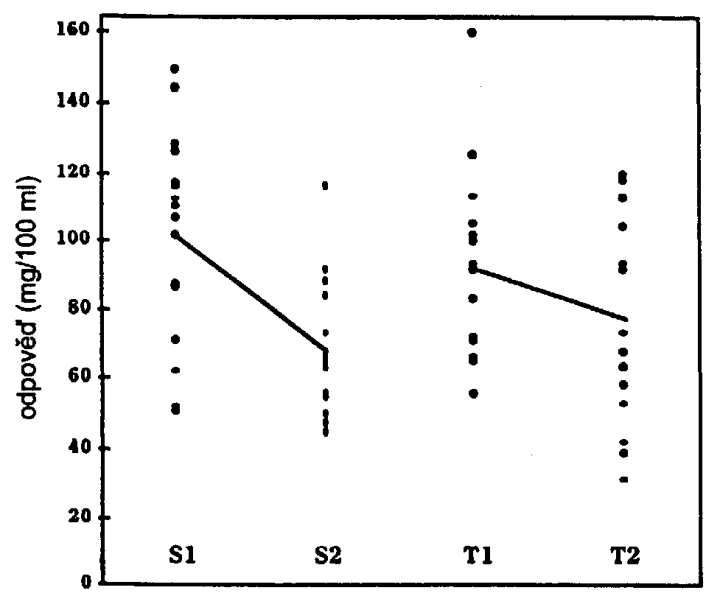
Obr. 5.1.5-I
Analýza rozptylu pro tento plán zkoušky je složitější než pro jiné plány, protože složka součtu čtverců tvořená odchylkou od rovnoběžnosti není nezávislá na složce tvořené rozdíly mezi králíky. Test rovnoběžnosti regresních přímek vyžaduje výpočet dalšího reziduálního součtu čtverců „uvnitř králíků“, který se získá odečtením složky rovnoběžnosti a dvou „interakcí“ od variability způsobené rozdíly mezi králíky.
- Díky opakování v každé skupině obsahuje analýza tři „interakce“:
- dny × přípravky, dny × regrese, dny × rovnoběžnost.
Tyto členy reprezentují náchylnost jednotlivých složek (efektu přípravku, regrese a rovnoběžnosti) měnit se den ode dne. Odpovídající F-test kontroluje platnost modelu se zřetelem na tuto skutečnost. Vysoce statisticky významné výsledky F-testu je třeba interpretovat opatrně a, pokud je to možné, zkoušku zopakovat.
Analýza rozptylu se provede dosazením do vzorců v tabulkách 3.2.3-I a 3.2.3-III zvlášť pro jednotlivé dny a pro oba dny společně. Výsledky po dosazení vzorců z tabulek 3.2.3-I a 3.2.3-II jsou:
1. den 2. den PS = 165,25 LS = -13 PS = 173,38 LS = -20,06 PT = 162,25 LT = -8,75 PT = 176,00 LT = -5,25 - oba dny dohromady:
PS = 169,31 LS = -16,53 PT = 169,13 LT = -7,00
- a ze vzorců z tabulky 3.2.3-III
1. den 2. den dohromady SSprip = 18,000 SSprip = 13,781 SSprip = 0,141 SSreg = 3784,5 SSreg = 5125,8 SSreg = 8859,5 SSrovnob = 144,5 SSrovnob = 1755,3 SSrovnob = 1453,5
- Složky interakce se vypočtou jako 1. den + 2. den - oba dny dohromady
- SSdny×prip = 31,64
- SSdny×reg = 50,77
- SSdny×par = 446,27
- Dále je součet čtverců způsobený rozdílu mezi dny roven:
- a součet čtverců způsobený rozdíly mezi bloky (mezi králíky) je:
- kde B1 je průměrná odpověď králíka.
Výsledky analýzy rozptylu jsou v tabulce 5.1.5-III.
Tab. 5.1.5-III
Zdroj variability Stupně volnosti Součet čtverců Průměrný tverec F-rozložení Pravděpodobnost nerovnoběžnost 1 1453,5 1453,5 1,064 0,311 dny × přípravek 1 31,6 31,6 0,023 0,880 dny × regrese 1 50,8 50,8 0,037 0,849 reziduální chyba mezi
králíky28 38 258,8 1366,4 králík 31 39 794,7 1283,7 přípravky 1 0,14 0,14 0,001 0,975 regrese 1 8859,5 8859,5 64,532 0,000 dny 1 478,5 478,5 3,485 0,072 dny × nerovnoběžnost 1 446,3 446,3 3,251 0,082 reziduální chyba
uvnitř králíků28 3844,1 137,3 celkem 63 53 423,2 Analýza rozptylu potvrdila splnění požadovaných podmínek zkoušky: Závislost na dávce (regrese) je silně významná a odchylka od předpokladu rovnoběžnosti a všechny tři interakce jsou statisticky nevýznamné.
- Dosazením do vzorců části 3.2.5 se získá:
- společný sklon
- logaritmus účinnosti
- a logaritmus mezí spolehlivosti je:
Odlogaritmováním se získá relativní účinnost 1,003 s 95% mezemi spolehlivosti od 0,835 do 1,204. Vynásobením AT = 40 se získá účinnost 40,1 jednotek na mililitr s 95% mezemi spolehlivosti od 33,4 do 48,2 jednotek na mililitr.
- Díky opakování v každé skupině obsahuje analýza tři „interakce“:
- 5.2 Model poměru sklonů
- 5.2.1 Úplně znáhodněný plán (0,3,3)
Stanovení účinnosti faktoru VIII
Laboratoř provádí stanovení účinnosti v koncentrátech faktoru VIII chromogenní metodou. Laboratoř nemá zkušenosti s tímto typem zkoušky, ale pokouší se ji provést operativně. Byla připravena tři stejná ředění pro referenční a zkoušený přípravek. Navíc byly připraveny i vzorky s nulovou dávkou, přestože nebyla předpokládána linearita závislosti odpovědi (absorbance y) na dávce (x v m.j.) pro velmi nízké hodnoty. Bylo připraveno osm opakování pro každé ředění, což je více, než bývá používáno u rutinních zkoušek.
Tab.5.2.1-I Absorbance
Nulová dávka Standard S
(v m.j./ml)Přípravek T
(v m.j./ml)koncentrace B S1 S2 S3 T1 T2 T3 0,01 0,02 0,03 ,01 0,02 0,03 0,022 0,133 0,215 0,299 0,120 0,188 0,254 0,024 0,133 0,215 0,299 0,119 0,188 0,253 0,024 0,131 0,216 0,299 0,118 0,190 0,255 0,026 0,136 0,218 0,297 0,120 0,190 0,258 0,023 0,137 0,220 0,297 0,120 0,190 0,257 0,022 0,136 0,220 0,305 0,121 0,191 0,257 0,022 0,138 0,219 0,299 0,121 0,191 0,255 0,023 0,137 0,218 0,302 0,121 0,190 0,254 průměr 0,0235 0,1351 0,2176 0,2996 0,1200 0,1898 0,2554 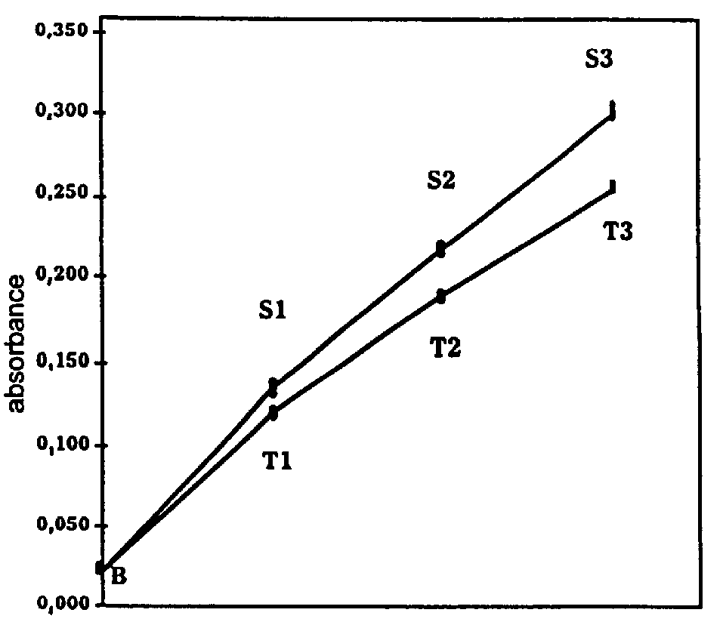
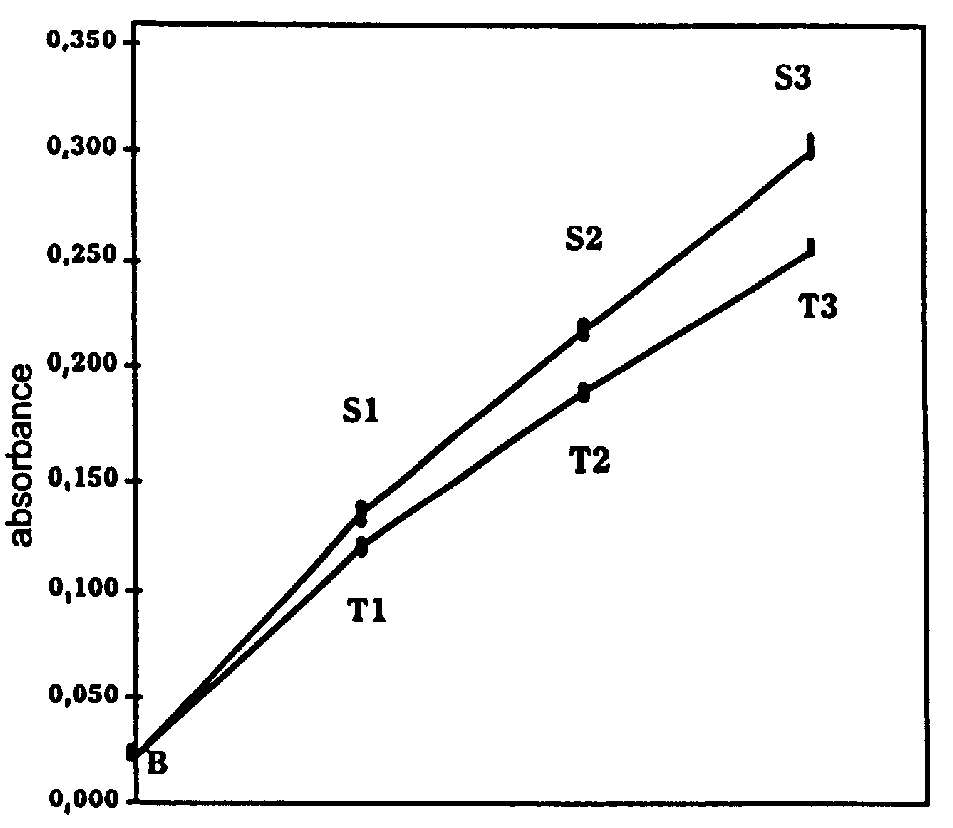
Obr. 5.2.1-I
Grafické zobrazení výsledků potvrzuje vizuálně, že závislost odpovědi na dávce skutečně není pro nízké dávky lineární. Odpověď na nulovou dávku nebude tedy použita pro výpočet (ke zdůvodnění tohoto rozhodnutí bude zapotřebí další zkoušky). Vzorce z tabulek 3.3.3-I a 3.3.3-II jsou:
PS = 0,6524 PT = 0,5651 LS = 1,4693 LT = 1,2656 aS = 0,318 aT = 0,318 bS = 0,329 bT = 0,217 GS = 0,1554 GT = 0,1156 JS = 4,17 × 10⁻⁸ JT = 2,84 × 10⁻⁶ a H1 = 0,09524 a’ = 0,05298 K = 1,9764 Analýza rozptylu je v tabulkách 5.2.1-II, 3.3.3.1-III a 3.3.3.1-IV.
Tab. 5.2.1-II AnaIýza rozptylu
Zdroj variability Stupně volnosti Součet čtverců Průměrný čtverec F-statistika Pravděpodobnost regrese 2 0,1917 0,0958 24 850 0,000 průsečík 1 3×10⁻⁹ 3×10⁻⁹ 7×10⁻⁹ 0,978 nelinearita 2 2×10⁻⁵ 1×10⁻⁵ 2,984 0,061 ošetření 5 0,1917 reziduální chyba 42 1,92×10⁻⁴ 3,86×10⁻⁶ celkem 47 0,1919 Byla tedy prokázána statisticky velmi významná závislost odpovědi na dávce, na rozdíl od statisticky nevýznamné odchylky od předpokladu linearity a společného průsečíku. Může být tedy vypočten odhad účinnosti.
K’ = 0,000083 × 0,75 = 0,000062
a 95% interval je
Odhadovaná relativní účinnost je tedy 0,823 s 95% mezemi spolehlivosti od 0,817 do 0,829.
- 5.2.2 Úplně znáhodněný plán (0,4,4,4)
Zkouška in vitro chřipkové vakcíny
U dvou chřipkových vakcín je zjišťován obsah haemaglutininového antigenu (HA) pomocí jednoduché radiální imunodifuse. Oba přípravky mají deklarovanou účinnost 15 μg HA na dávku, což je ekvivalentní 30 μg HA/ml. Standard má referenční účinnost 39 μg HA/ml.
Standard a zkoušený přípravek byly připraveny ve čtyřech koncentracích po dvou opakováních připravených na základě referenční a deklarované účinnosti. Po ustálení reakcí byla změřena zóna prstence sraženiny. Výsledky jsou zobrazeny v tabulce 5.2.2-I.
Tabulka 5.2.2-I Zóny srážení (mm2)
Koncentrace
(μg/ml)Standard S Přípravek T Přípravek U I II I II I II 7,5 18,0 18,0 15,1 16,8 15,4 15,7 15,0 22,8 24,5 23,1 24,2 20,2 18,6 22,5 30,4 30,4 28,9 27,4 24,2 23,1 30,0 35,7 36,6 34,4 37,8 27,4 27,0 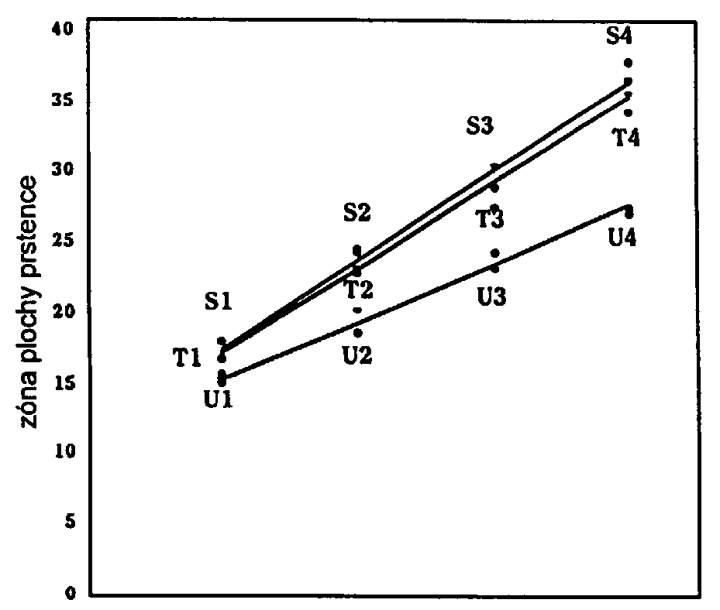
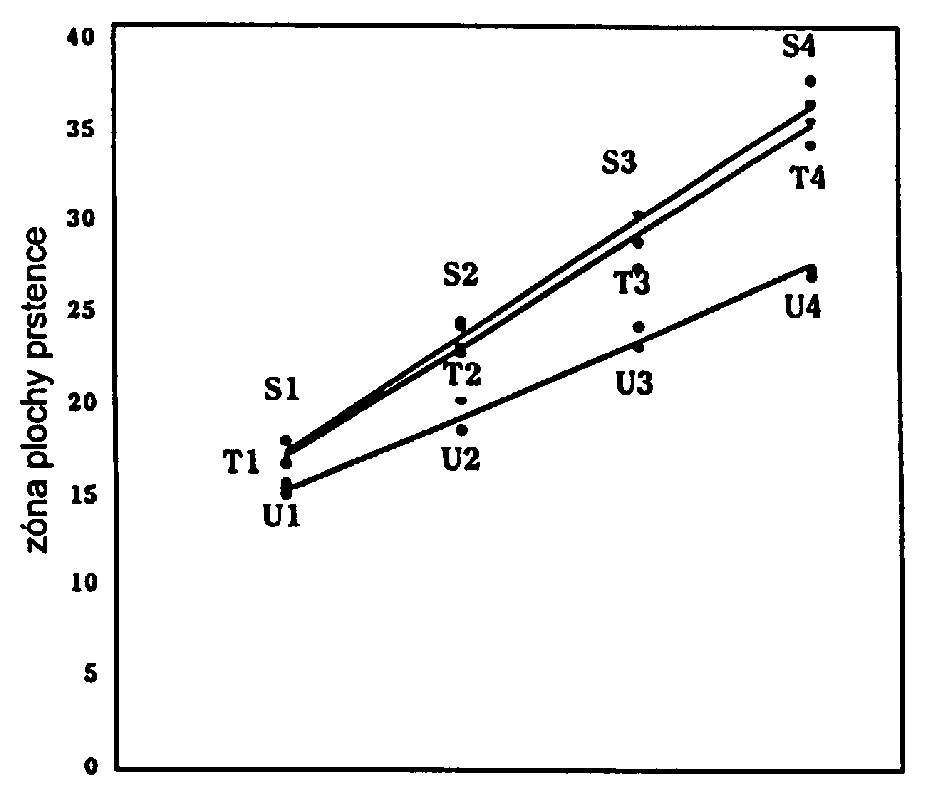
Obr. 5.2.2-I
Grafické zobrazení výsledků nenaznačuje žádnou neobvyklost. Výsledky vzorců z tabulek 3.3.3-I a 3.3.3-II dávají tyto výsledky:
PS = 108,2 PT = 103,85 PU = 85,8 LS = 301,1 LT = 292,1 LU = 234,1 aS = 141,0 aT = 116,7 aU = 139,8 bS = 61,2 bT = 64,95 bU = 39,2 GS = 3114,3 GT = 2909,4 GU = 1917,3 JT = 2,227 JU = 0,083 a HI = 0,0093 a’ = 11,04 K = 14 785,8 - a dále se vypočte analýza rozptylu, viz tabulka 5.2.2-II, za použití vzorců z tabulek 3.3.3.1-III a 3.3.3.1-IV.
Tabulka 5.2.2.-II Analýza rozptylu
Zdroj variability Stupně volnosti Součet čtverců Průměrný tverec F-statistika Pravděpodobnost regrese 3 1087,7 362,6 339,5 0,000 průsečík 2 3,474 1,737 1,626 0,237 nelinearita 6 5,066 0,844 0,791 0,594 ošetření 11 1096,2 reziduální chyba 12 12,815 1,068 celkem 23 1109,0 Byla tedy prokázána statisticky velmi významná závislost odpovědi na dávce, na rozdíl od statisticky nevýznamné odchylky od předpokladu linearity a společného průsečíku. Může být tedy vypočten odhad účinnosti
To vede k odhadu relativní účinnosti pro vakcínu T a pro vakcínu U.
K’ = 0,0056 × 0,625 = 0,0035.
- A meze spolehlivosti jsou podle vzorce 3.3.5.1-4 rovny:
- pro vakcínu T
- a pro vakcínu U
Množství HA na ml se může odhadnout vynásobením relativní účinnosti a jejích mezí spolehlivosti předpokládaným obsahem 30 μg/ml. Výsledky jsou v tabulce 5.2.2-III.
Tab. 5.2.2-III Odhad obsahu HA (μg/ml)
Dolní mez Odhad Horní mez vakcína T 13,4 14,3 15,3 vakcína U 8,9 9,7 10,6
- 5.2.1 Úplně znáhodněný plán (0,3,3)
- 5.3 Kvantální zkoušky
- 5.3.1 Probitová analýza, zkoušení přípravku proti referenčnímu vzorku
Zkouška in vitro vakcíny difterie
Vakcína difterie (s předpokládanou účinností 140 m.j./lahvičku) byla testována oproti standardu (s referenční účinností 132 m.j./lahvičku). Na základě této informace byly připraveny ekvivalentní dávky. Ty byly náhodně přiděleny skupinám morčat. Po daném časovém intervalu byla morčata imunizována toxinem difterie a dále byly zaznamenány počty zvířat, které přežily, viz. tabulka 5.3.1-I.
Tab. 5.3.1-I Výchozí data zkoušky difterie na morčatech
Standard (S)
stanovená účinnost 140 m.j./mlZkoušený přípravek (T)
předpokládaná účinnost 140 m.j./mlDávka
(m.j./ml)Počet
exponovanýchPočet
přeživšíchDávka
(m.j./ml)Počet
exponovanýchPočet
přeživších1,0 12 0 1,0 11 0 1,6 12 3 1,6 12 4 2,5 12 6 2,5 11 8 4,0 11 10 4,0 11 10 Pozorování byla přenesena do první pracovní tabulky, kde jsou vypočteny ještě další sloupce tak, jak je popsáno v části 4.2.1. Tabulka 5.3.1-II obsahuje první iterační cyklus.
Jsou vypočteny součty posledních šesti sloupců a přeneseny do druhé pracovní tabulky, viz tabulka 5.3.1-III. Ostatní sloupce jsou vypočteny pomocí vzorců 4.2.1-4 až 4.2.1-10. Odtud se získá i společný sklon b = 1,655 (podle vzorce 4.2.1-9).
Hodnoty Y v první pracovní tabulce se nyní nahradí hodnotami a+bx a provede se druhý iterační cyklus, viz tabulka 5.3.1-IV.
Iterační cyklus se opakuje, dokud není rozdíl mezi po sobě následujícími cykly dostatečně malý. Tak se získá druhá pracovní tabulka 5.3.1-V.
Tab. 5.3.1-II První pracovní tabulka v prvním iteračním cyklu
Dávka n r x p Y Φ Z y w wx wy wx2 wy2 wxy S 1,0 12 0 0,000 0,000 0 0,5 0,399 -1,523 7,64 0,00 -9,57 0,00 12,00 0,00 1,6 12 3 0,470 0,250 0 0,5 0,399 -0,627 7,64 3,59 -4,79 1,69 3,00 -2,25 2,5 12 6 0,916 0,500 0 0,5 0,399 0,000 7,64 7,00 0,00 6,41 0,00 0,00 4,0 11 10 1,386 0,909 0 0,5 0,399 1,025 7,00 9,71 7,18 13,46 7,36 9,95 T 1,0 11 0 0,000 0,000 0 0,5 0,399 -1,253 7,00 0,00 -8,78 0,00 11,00 0,00 1,6 12 4 0,470 0,333 0 0,5 0,399 -0,412 7,64 3,59 -3,19 1,69 1,33 -1,50 2,5 11 8 0,916 0,727 0 0,5 0,399 0,570 7,00 6,42 3,99 5,88 2,27 3,66 4,0 11 10 1,386 0,909 0 0.5 0,399 1,025 7,00 9,71 7,18 13,46 7,36 9,95 Tab. 5.3.1-III Druhá pracovní tabulka v prvním iteračním cyklu
Σw Σwx Σwy Σwx2 Σwy2 Σwxy Sxx Sxy Syy 

a S 29,92 20,30 -7,18 21,56 22,36 7,70 7,79 12,58 20,64 0,68 -0,24 -1,36 T 28,65 19,72 -0,80 21,03 21,97 12,11 7,64 12,66 21,95 0,69 -0,03 -1,17 Tab. 5.3.1-IV První pracovní tabulka v druhém iteračním cyklu
Dávka n r x p Y Φ Z y w wx wy wx2 wy2 wxz S 1,0 12 0 0,000 0,000 -1,36 0,086 0,158 -1,911 3,77 0,00 -7,21 0,00 13,79 0,00 1,6 12 3 0,470 0,250 -0,58 0,279 0,336 -0,672 6,74 3,17 -4,53 1,49 3,04 -2,13 2,5 12 6 0,916 0,500 0,15 0,561 0,394 -0,001 7,57 6,94 -0,01 6,36 0,00 -0,01 4,0 11 10 1,386 0,909 0,93 0,824 0,258 1,260 5,07 7,03 6,39 9,75 8,05 8,86 T 1,0 11 0 0,000 0,000 -1,17 0,122 0,202 -1,769 4,20 0,00 -7,43 0,00 13,14 0,00 1,6 12 4 0,470 0,333 -0,39 0,349 0,370 -0,430 7,23 3,40 -3,11 1,60 1,34 -1,46 2,5 11 8 0,916 0,727 0,35 0,637 0,375 0,591 6,70 6,14 3,96 5,62 2,34 3,63 4,0 11 10 1,386 0,909 1,13 0,870 0,211 1,311 4,23 6,03 5,70 8,36 7,48 7,90 Tab. 5.3.1-V Druhá pracovní tabulka po dostatečném počtu cyklů.
Σw Σwx Σwy Σwx2 Σwy2 Σwxy Sxx Sxy Syy a S 18,37 14,80 -2,14 14,85 17,81 5,28 2,93 7,00 17,56 0,81 -0,12 -2,05 T 17,96 12,64 -0,55 11,86 18,35 6,76 2,96 7,15 18,34 0,70 -0,03 -1,72 Test linearity je popsán v části 4.2.2. Hodnota o 4 stupních volnosti je 0,836 + 1,069 = 1,905 a té odpovídá p-hodnota 0,780, což neprokazuje statisticky významnou odchylku od linearity.
Protože odchylka od linearity není statisticky významná, je možno provést test rovnoběžnosti popsaný ve stejné části. s jedním stupněm volnosti je To odpovídá p-hodnotě 0,964, což není statisticky významné.
- Z tabulky 5.3.1-V se podle vzorce 4.2.1-9 vypočte:
- pomocí vzorců z části 4.2.3 je možno odhadnout logaritmus relativní účinnosti
- dále
- takže ln mezí spolehlivosti je:
Odlogaritmováním a vynásobením předpokládanou účinností (140 m.j./lahvičku) se získá účinnost a její meze spolehlivosti. Odhad účinnosti je 160,6 m.j./lahvičku s 95% mezemi spolehlivosti od 121,0 do 215,2 m.j./lahvičku.
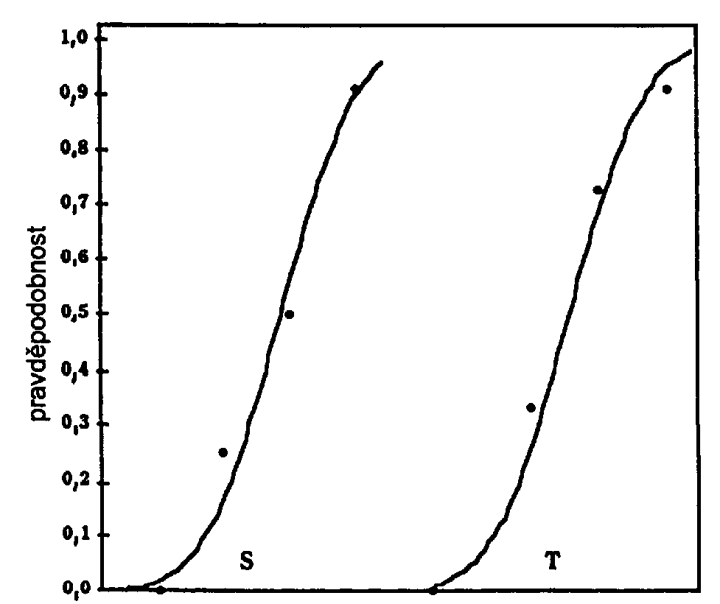
Obr. 5.3.1-I
- Z tabulky 5.3.1-V se podle vzorce 4.2.1-9 vypočte:
- 5.3.2 Logitová analýza a jiné typy analýzy zkoušeného přípravku proti referenčnímu vzorku
V této části jsou uvedeny výsledky analýz dat z části 5.3.1 získané logitovou analýzou a jinými klasickými metodami. Následující příklad by měl být spíše považován za cvičení než za alternativní řešení příkladu v části 5.3.1. Jiný tvar křivky by měl být použit pouze, pokud pro to existují dostatečné empirické nebo teoretické důvody.
Tab. 5.3.2.-I Výsledky použití alternativních křivek
Logit Gompit Sinit(*) Φ Z sklon b 4,101 2,590 1,717 χ2 linearity 2,15 3,56 1,50 χ2 rovnoběžnosti 0,0066 0,168 0,0010 účinnost 162,9 158,3 155,8 dolní mez 121,1 118,7 122,6 horní mez 221,1 213,3 200,7 - (*) Je-li pak Φ = 0 a Z = 0 a je-li pak Φ = 1 a Z = 0.
- 5.3.1 Probitová analýza, zkoušení přípravku proti referenčnímu vzorku


- 5.3.3 Stanovení ED50 přípravku pomocí probitové metody
In vitro zkouška peroralní poliomyelitické vakcíny
Pro stanovení ED50 peorální poliomyelitické vakcíny bylo použito 10 ředění s osmi opakováními 50 μl na Elisaplotnách, výsledky zkoušky jsou v tabulce 5.3.3-I.
Tab. 5.3.3-I Ředění (10x μl původní vakcíny)
-3,5 -4,0 -4,5 -5,0 -5,5 -6,0 -6,5 -7,0 -7,5 -8,0 + + + + - - - - - - + + + + - - - - - - + + - - - - - - - - + + + + - - - - - - + + + - - - - - - - + + + + + - - - - - + + + + + - + - - - + + + + - + - - - - Pozorované výsledky jsou převedeny do první pracovní tabulky a v ní jsou vypočteny i ostatní sloupce, jak jsou popsány v části 4.2.1. V tabulce 5.3.3-II je zobrazen první cyklus iterační procedury.
Dále je vypočten součet posledních šesti sloupců a převeden do druhé pracovní tabulky (viz tabulka 5.3.3-III). Pomocí vzorců 4.2.1-4 až 4.2-10 se vypočtou zbylé sloupce a získá se společný sklon b = -0,295.
Hodnoty Y v první pracovní tabulce se nahradí hodnota a + bx a dokončí se druhý iterační cyklus. V iteračním procesu se pokračuje, dokud není rozdíl mezi dvěma po sobě následujícími cykly dostatečně malý. Tabulka 5.3.3-IV obsahuje údaje z druhé pracovní tabulky po ukončení iteračního procesu.
Tab. 5.3.3-I První pracovní tabulka prvního iteračního cyklu
Dávka n r x p Y Φ Z Y w wx wy wx2 wy2 wxy T 10-3,5 8 0 -8,06 0,000 0,00 0,5 0,399 -1,253 5,09 -41,04 -6,38 330,8 8,00 51,4 10-4,0 8 0 -9,21 0,000 0,00 0,5 0,399 -1,253 5,09 -46,91 -6,38 432,0 8,00 58,8 10-4,5 8 1 -10,36 0,125 0,00 0,5 0,399 -0,940 5,09 -52,77 -4,79 546,8 4,50 49,6 10-5,0 8 2 -11,51 0,250 0,00 0,5 0,399 -0,627 5,09 -58,63 -3,19 675,1 2,00 36,7 10-5,5 8 6 -12,66 0,750 0,00 0,5 0,399 0,627 5,09 -64,50 3,19 816,8 2,00 -40,4 10-6,0 8 7 -13,82 0,875 0,00 0,5 0,399 0,940 5,09 -70,36 4,79 972,1 4,50 -66,1 10-6,5 8 7 -14,97 0,875 0,00 0,5 0,399 0,940 5,09 -76,23 4,79 1140,8 4,50 -71,7 10-7,0 8 8 -16,12 1,000 0,00 0,5 0,399 1,253 5,09 -82,09 6,38 1323,1 8,00 -102,9 10-8,5 8 8 -17,27 1,000 0,00 0,5 0,399 1,253 5,09 -87,95 6,38 1518,9 8,00 -110,2 10-8,0 8 8 -18,42 1,000 0,00 0,5 0,399 1,253 5,09 -93,82 6,38 1728,2 8,00 -117,6 Tab. 5.3.3-II Druhá pracovní tabulka prvního iteračního cyklu
Σw Σwx Σwy Σwx2 Σwy2 Σwx Sxx Sxy Syy a T 50,93 -674,3 11,17 9484,6 57,50 -312,4 556,92 -164,43 55,05 -13,24 0,219 -3,690 Tab. 5.3.3-III Druhá pracovní tabulka po provedení dostatečného počtu iterací
Σw Σwx Σwy Σwx2 Σwy2 Σwx Sxx Sxy Syy a T 19,39 -238,2 0,11 2981,1 26,05 -37,45 55,88 -36,11 26,05 -12,28 0,006 -7,931 Linearita se otestuje pomocí vzorců z části 4.2.2. Hodnota Χ2 o osmi stupních volnosti je 2,711 a tomu odpovídá p-hodnota 0,951, což není statisticky významné.
- Je tedy možno pomocí vzorců z části 4.5 odhadnout relativní účinnost,
- dále
- Logaritmus mezí spolehlivosti je tedy roven
- Tento odhad je stále ve tvaru ln(ředění). Odhad vyjádřený jako ln(ED50)/ml je
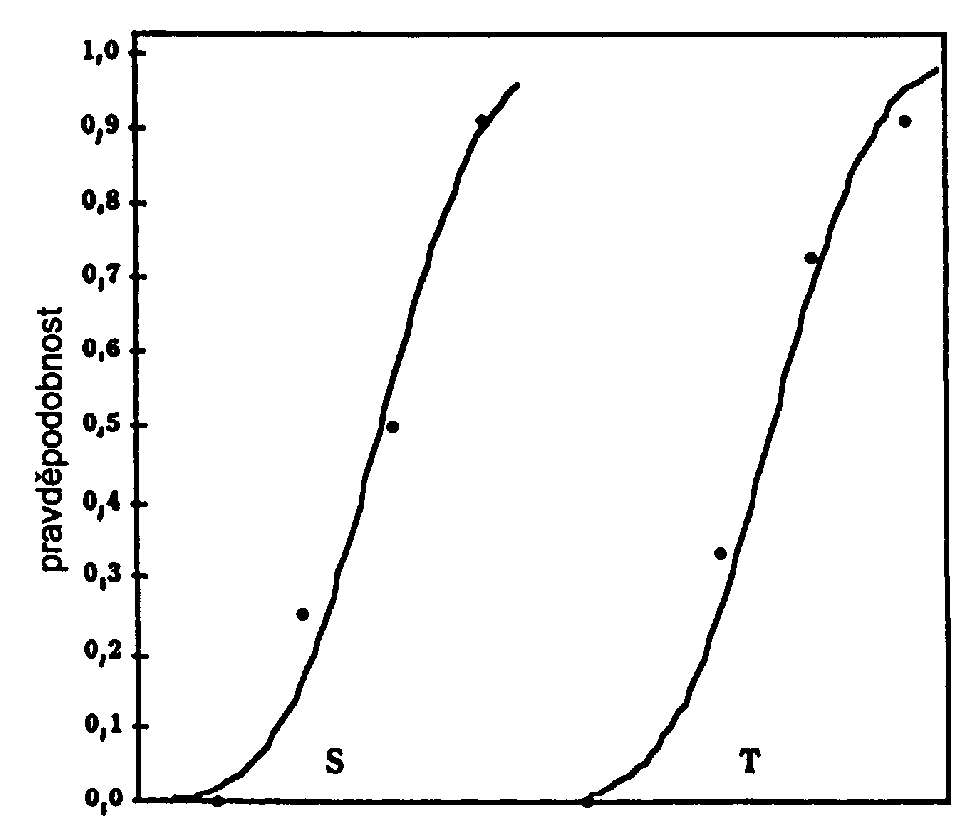
Protože je obvyklé vyjadřovat účinnost této vakcíny ve tvaru log10(ED50)/ml výsledky musí být vyděleny ln(10). Odhadem účinnosti pak je 6,63 log10(ED50)/ml s 95% mezemi spolehlivosti od 6,30 do 6,96 log10(ED50)/ml.
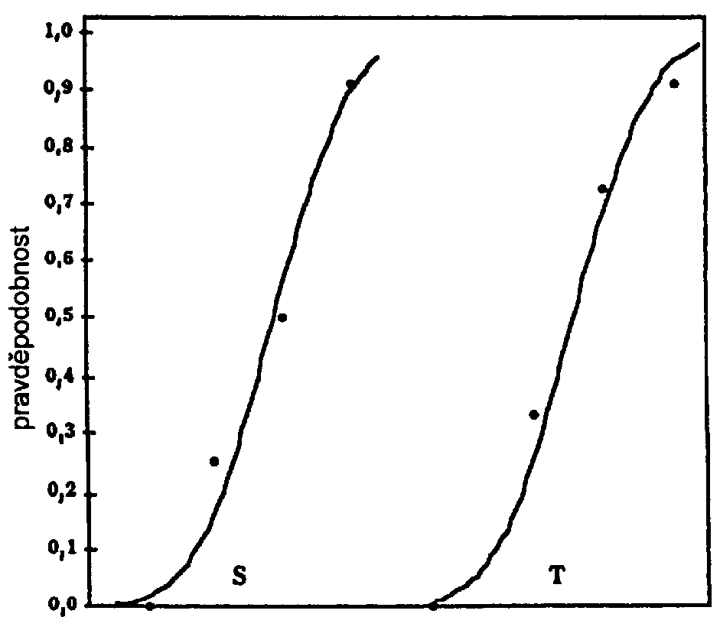
Obr. 5.3.3-I. Závislost pravděpodobnosti pozitivní odpovědi na ředění
- Je tedy možno pomocí vzorců z části 4.5 odhadnout relativní účinnost,
- 6 Kombinace výsledků zkoušky
- 6.1 Úvod
Ke splnění požadavků lékopisu je často nutné zkoušku nezávisle opakovat a výsledky kombinovat. Pak se naskýtá otázka, zda je vhodné kombinovat takové zkoušky, a pokud ano, jakým způsobem.
Zkoušky lze považovat za navzájem nezávislé, když výsledky jedné zkoušky neovlivňují výsledky jiné. Také náhodné chyby ve všech faktorech ovlivňujících výsledek (např. ředění standardu a zkoušeného přípravku, citlivost biologického ukazatele) v jedné zkoušce musí být nezávislé na stejné chybě ve druhé zkoušce. Zkoušky ve dnech po sobě následujících, používající původní ředění standardu, tedy nezávislé nejsou.
Existuje několik způsobů kombinování výsledků nezávislých zkoušek, ty teoreticky nejvhodnější jsou ale také nejobtížněji použitelné. Dále jsou popsány tři přibližné metody. Mohou být použity i další za předpokladu splnění nutných podmínek.
Před kombinováním odhadů účinnosti získaných pomocí modelu rovnoběžnosti je nutné pracovat s logaritmem účinnosti. Při použití modelu poměru sklonů se pracuje přímo s účinností. Protože v praxi je častěji používán model rovnoběžnosti než model poměru sklonů, je použit v této části symbol M označující přirozený logaritmus účinnosti. Při modelu poměru sklonů se použijí stejné vzorce, v nichž se pod M rozumí účinnost R, a nikoliv její logaritmus. Před kombinováním musí být všechny odhady účinnosti upraveny na stanovenou účinnost každého zkoušeného přípravku.
- 6.2 Vážený průměr výsledků zkoušek
- Podmínky použití této metody:
- 1. odhady účinnosti jsou z nezávislých zkoušek,
- 2. v každé zkoušce je C blízké 1 (menší než 1,1),
- 3. počet stupňů volnosti jednotlivých reziduálních chyb není menší než 6, pokud možno je větší než 15,
- 4. jednotlivé odhady účinnosti tvoří homogenní skupinu. Test homogenity je popsán v části 6.2.2.
Pokud tyto podmínky nejsou splněny, metodu nelze použít. Metody v následující části 6.3 mohou sloužit k získání nejlepšího odhadu průměrné účinnosti jako předpokládané účinnosti pro další zkoušky.
- 6.2.1 Výpočet váhových koeficientů
Po vyhodnocení každé z n´ nezávislých validních zkoušek je k dispozici n´ hodnot M a příslušných mezí spolehlivosti. Pro každou zkoušku se určí délka intervalu spolehlivosti L jako rozdíl horní a dolní meze. Váha W pro každou hodnotu M se vypočte pomocí vzorce 6.2.1-I, kde t je stejná hodnota jako při výpočtu mezí spolehlivosti:
- 6.2.2 Homogenita odhadů účinnosti
Umocněním každé odchylky M od váženého průměru, vynásobením příslušnou váhou W a součtem přes všechny zkoušky se získá statistika s přibližně χ2 rozdělením. Ta může být použita k testování homogenity odhadů logaritmů účinnosti v n´ nezávislých zkouškách.
Je-li vypočtené χ2 menší než tabelovaná hodnota pro (n´- 1) stupňů volnosti, není významně porušena homogenita účinností a je možno průměrnou účinnost a meze spolehlivosti určit pomocí metody z části 6.2.3.
Je-li χ2 větší než tabelovaná hodnota, jsou účinnosti nehomogenní. To znamená, že rozdíly mezi jednotlivými odhady M jsou významně větší, než odpovídá odhadům jejich mezí spolehlivosti, tj. je statisticky významná variabilita mezi zkouškami. Rozdíly mezi zkouškami jsou tedy významné, takže podmínka 4 není splněna a není možno použít vzorce z části 6.2.3, místo nich se použijí vzorce ze části 6.2.4.
- 6.2.3 Výpočet vážených průměrů a mezí spolehlivosti
Pro výpočet váženého průměru logaritmů účinností se vypočtou součiny WM pro každou zkoušku a jejich součet se vydělí celkovým součtem vah všech zkoušek.
Střední chyba ln(průměrné účinnosti) je odmocnina převrácené hodnoty součtu všech hmotností.
- Přibližné meze spolehlivosti se získají odlogaritmováním hodnot:
- kde počet stupňů volnosti t je roven součtu stupňů volnosti střední chyby jednotlivých zkoušek.
- Přibližné meze spolehlivosti se získají odlogaritmováním hodnot:
- 6.2.4 Vážený průměr a meze spolehlivosti založené na vnější a vnitřní individuální variabilitě zkoušky
- Pokud je kombinováno několik opakování zkoušek, může být hodnota χ2 statisticky významná. Pak se pozorovaný rozptyl skládá ze dvou složek:
- • intra zkoušková variabilita
- • inter zkoušková variabilita
- kde je nevážený průměr. První složka se mění zkoušku od zkoušky, zatímco druhá je společná pro všechna M.
- Pro každé M se vypočte váhový koeficient
- který nahradí W části 6.2.3, kde je t aproximováno hodnotou 2.
- Pokud je kombinováno několik opakování zkoušek, může být hodnota χ2 statisticky významná. Pak se pozorovaný rozptyl skládá ze dvou složek:
- Podmínky použití této metody:
- 6.3 Nevážená kombinace výsledků zkoušek
- Nejjednodušší způsob kombinace n´ odhadů M z n´ zkoušek je vypočítat průměr
 a jeho směrodatnou odchylku odhadnout jako
- Meze spolehlivosti pak jsou
- kde t má (n´ - 1) stupňů volnosti. Počet n´ odhadů M je obvykle malý, proto bývá hodnota t poměrně velká.
- Nejjednodušší způsob kombinace n´ odhadů M z n´ zkoušek je vypočítat průměr
- 6.4 Příklad vážené průměrné účinnosti a jejích mezí spolehlivosti
V tabulce 6.4-I je šest nezávisIých odhadů účinnosti stejného přípravku společně s jejich 95% intervaly spolehlivosti a s počtem stupňů volnosti jejich reziduálních směrodatných odchylek. Podmínky 1, 2 a 3 části 6.2 jsou splněny. Logaritmy účinností a váhy jsou vypočteny tak, jak je popsáno v části 6.2.
Tab. 6.4-I Odhady účinnosti a intervaly spolehlivosti šesti nezávislých zkoušek.
Odhad účinnosti
(m.j./lahvičku)Dolní mez
(m.j./lahvičku)Horní mez
(mj./lahvičku)Stupně volnosti ln účinnosti M Váhy W 18 367 17 755 19 002 20 9,8183 3777,7 18 003 17 415 18 610 20 9,7983 3951,5 18 064 17 319 18 838 20 9,8017 2462,5 17 832 17 253 18 429 20 9,7887 4003,0 18 635 17 959 19 339 20 9,8328 3175,6 18 269 17 722 18 834 20 9,8130 4699,5 Homogenita odhadů účinnosti je hodnocena vzorcem 6.2.2-1, který poskytuje hodnotu χ2 = 4,42, který má 5 stupňů volnosti, což není statisticky významné (p = 0,49). Podmínky jsou tedy splněny.
Vážený průměr vypočtený vzorcem 6.2.3-1 je roven 9,8085.
Vzorec 6.2.3-2 poskytuje odhad směrodatné odchylky 0,00673. Přibližné 95% meze spolehlivosti od 9,7951 do 9,8218 se získají ze vzorce 6.2.3-3, kde t má 120 stupňů volnosti.
Po odlogaritmování je odhad účinnosti rovný 18 187 m.j./lahvičku a 95% meze spolehlivosti od 17 946 do 18 431 m.j./lahvičku.
- 6.1 Úvod

- 7 Další postupy
Není možné, aby lékopisný text obsahoval úplný popis statistických metod. Nicméně metody popsané v této stati by měly stačit pro většinu lékopisných potřeb. Tato část se pokouší dát abstraktnější přehled alternativních nebo obecnějších metod, které byly vyvinuty. Čtenář zajímající se o tuto problematiku by se měl věnovat studiu další literatury z této oblasti. Použití speciálnějších statistických metod musí být v každém případě prováděno kvalifikovanou osobou.
- 7.1 Obecný lineární model
Metody zmíněné v tomto textu mohou být popsány prostřednictvím obecného lineárního modelu (nebo zobecněný lineární model zahrnuje probitovou a logitovou metodu). Nejprve je nutno definovat lineární strukturální matici X (nebo matici plánu), ve které každý řádek představuje jedno pozorování a každý sloupec lineární efekt (přípravek, blok, sloupec, dávku). Např. plán latinských čtverců z příkladu 5.1.2 je popsán maticí s 36 řádky a 13 sloupci. Jeden sloupec pro každý přípravek, jeden sloupec pro každou dávku, pět sloupců pro každý blok s výjimkou prvního. Všechny sloupce s výjimkou sloupců pro dávky jsou vyplněny čísly 0 nebo 1 podle toho, zda tomuto pozorování odpovídá příslušný efekt. Vektor Y obsahuje (transformované) pozorované hodnoty. Efekty jsou odhadovány vzorcem (X' X)-1 X' Y a z nich jako podíl odpovídajících efektů se vypočte odhad účinnosti m. Intervaly spolehlivosti se vypočtou pomocí Fiellerovy věty:
- a v11, v22 a v12 představují rozptyly čitatele, jmenovatele a jejích kovarianci. Ty se získají přímo z (X' X)-1 nebo nepřímo z var (a1 - a2) = var (a1) + var (a2) - 2cov (a1, a2) a cov (a1 - a2, b) = cov (a1, b) - cov (a2, b).
Úplná analýza rozptylu, ve které jsou obsaženy všechny komponenty, je poněkud komplikovanější. Matice X by musela být rozšířena o další sloupce, umožňující testovat předpoklad rovnoběžnosti a linearity. Pro zkoušku závisející na kvantální odpovědi se najdou lineární efekty (průsečíky as, aT atd. a společný sklon b se získá maximalizací součtu n ln Φ(ai + bx) + (n - r)ln(1 - Φ(ai + bx)), kde je x logaritmus dávky, Φ představuje tvar rozložení a i є {S, T, ...}.
- 7.2 Heterogenita rozptylů
Heterogenitu rozptylů se vždy nepodaří odstranit jednoduchou transformací odpovědí. Vhodnou cestou k řešení tohoto problému je použití vážené lineární regrese. K získání nevychýlených odhadů se za váhu pozorování použijí převrácené hodnoty rozptylů chyb. Protože skutečná hodnota rozptylu chyby není vždy známa, může být použita iterační metoda opakovaného vážení. Výpočet intervalů spolehlivosti ale přináší další problémy.
- 7.3 Odlehlá pozorování a robustní metody
Metoda nejmenších čtverců, popsaná v tomto textu, má nevýhodu v tom, že je silně ovlivněna případnými odlehlými pozorováními. Jasně odlehlá pozorování mohou zcela znehodnotit celý výpočet. Tento problém se obvykle řeší vyloučením odlehlých hodnot ze zpracovávaných dat. Tento postup může vést k účelovému zamítnutí libovolných dat a to není bez nebezpečí. Je složité dát obecný návod, jak rozhodnout, zda konkrétní pozorování je, či není odlehlé. Pro tyto účely bylo vyvinuto mnoho robustních metod. Tyto metody jsou méně citlivé na odlehlá pozorování, protože kladou menší důraz na hodnoty vzdálené od předpokládaného odhadu. Nové problémy se obvykle objeví při konstrukci intervalu spolehlivosti nebo definici minimalizované ztrátové funkce.
- 7.4 Korelace chyb
Úplné znáhodnění není vždy uskutečnitelné nebo je velmi nežádoucí z praktického důvodu. Pak jednotlivé dávky v ředicí řadě vedou ke korelovaným chybám způsobujícím, že meze spolehlivosti jsou mnohem užší. Byly vyvinuty metody, které berou v úvahu tento efekt autokorelace.
- 7.1 Obecný lineární model
- 8 Tabulky a algoritmy
V tabulkách této části jsou otištěny kritické hodnoty pro nejčastěji se vyskytující stupně volnosti. Pokud některé kritické hodnoty zde nejsou uvedeny, je nutno použít rozsáhlejší statistické tabulky. Mnohé počítačové programy v sobě zahrnují statistické funkce, ty pak jsou vhodnější než tabulky v této části. Jinou alternativou jsou dále popsané procedury, které vypočtou pravděpodobnost odpovídající daným statistikám při zadaných stupních volnosti.
- 8.1 Tabulka kritických hodnot F-rozdělení
sv1→ 1 2 3 4 5 6 8 10 12 15 20 ∞ sv2↓ 10 4,965 4,103 3,708 3,478 3,326 3,217 3,072 2,978 2,913 2,845 2,774 2,538 10,044 7,559 5,994 5,994 5,636 5,386 5,057 4,849 4,706 4,558 4,405 3,909 12 4,747 3,885 3,490 3,259 3,106 2,996 2,849 2,753 2,687 2,617 2,544 2,296 9,330 6,927 5,953 5,412 5,064 4,821 4,499 4,296 4,155 4,010 3,858 3,361 15 4,543 3,682 3,287 3,056 2,901 2,790 2,641 2,544 2,475 2,403 2,328 2,066 8,683 6,359 5,417 4,893 4,556 4,318 4,004 3,805 3,666 3,522 3,372 2,868 20 4,351 3,493 3,098 2,866 2,711 2,599 2,447 2,348 2,278 2,203 2,124 1,843 8,096 5,849 4,938 4,431 4,103 3,871 3,564 3,368 3,231 3,088 2,938 2,421 25 4,242 3,385 2,991 2,759 2,603 2,490 2,337 2,236 2,165 2,089 2,007 1,711 7,770 5,568 4,657 4,177 3,855 3,627 3,324 3,129 2,993 2,850 2,699 2,169 30 4,171 3,316 2,922 2,690 2,534 2,421 2,266 2,165 2,092 2,015 1,932 1,622 7,562 5,390 4,510 4,018 3,699 3,473 3,173 2,979 2,843 2,700 2,549 2,006 50 4,034 3,183 2,790 2,557 2,400 2,286 2,130 2,026 1,952 1,871 1,784 1,438 7,171 5,057 4,199 3,720 3,408 3,186 2,890 2,698 2,563 2,419 2,265 1,683 ∞ 3,841 2,996 2,605 2,372 2,214 2,099 1,938 1,831 1,752 1,666 1,571 1,000 6,635 4,605 3,782 3,319 3,017 2,802 2,511 2,321 2,185 2,039 1,878 1,000 Pokud je pozorovaná hodnota větší než tabelovaná, je test považován za statisticky významný (horní řádek, p = 0,05) nebo vysoce statisticky významný (dolní řádek, p = 0,01). sv1 je počet stupňů volnosti čitatele a sv2 jmenovatele.
Počítačový postup: Nechť F je vypočtená testovací statistika, sv1, sv2 výše popsané stupně volnosti a pi = π = 3,14159265358979.... Následující program vypočte odpovídající p-hodnotu.
Je-li sv1 sudé Je-li sv1 liché a sv2 sudé Je-li sv1 a sv2 liché x=sv1 / (sv1+sv2/F) x=sv2/ (sv2+sv1*F) x=atn(sqr(sv1*F/sv2)) s=1 : t=1 s=1 : t=1 cs=cos (x) : sn=sin(x) : x=x/2 for i=2 to (sv1-2) step 2 for i=2 to (sv2-2) step 2 s=0 : t=sn*cs/2 : v=0 : w=1 t=t*x*(sv2+i-2)/i t=t*x* (sv1+i-2)/i for i=1 to (sv2-1) step 2 s=s+t s=s+t s=s+t next i next i t=t*i/(i+1)*cs*cs p=s*(1-x)^(sv2/2) p=1-s*(1-x)^(sv1/2) next i for i=1 to (sv1-2) step 2 v=v+w w=w* (sv2+i) / (i+2) *sn*sn next i p=1+(t*sv2*v-x-s) / pi*4
- 8.2 Tabulka kritických hodnot t- rozdělení
sv p = 0,05 p = 0,01 1 12,706 63,656 2 4,303 9,925 3 3,182 5,841 4 2,776 4,604 5 2,571 4,032 6 2,447 3,707 7 2,365 3,499 8 2,306 3,355 9 2,262 3,250 10 2,228 3,169 12 2,179 3,055 14 2,145 2,977 16 2,120 2,921 18 2,101 2,878 20 2,086 2,845 22 2,074 2,819 24 2,064 2,797 26 2,056 2,779 28 2,048 2,763 30 2,042 2,750 35 2,030 2,724 40 2,021 2,704 45 2,014 2,690 50 2,009 2,678 60 2,000 2,660 70 1,994 2,648 80 1,990 2,639 90 1,987 2,632 100 1,984 2,626 ∞ 1,960 2,576 Pokud je pozorovaná hodnota větší než tabelovaná, je test považován za statisticky významný (horní řádek, p = 0,05) nebo vysoce statisticky významný (dolní řádek, p = 0,01).
Počítačový postup: p-hodnota pro t-rozdělení s sv stupni volnosti se vypočte pomocí postupu v části 8.1, kde F = t2, sv1 = 1 a sv2 = sv.
Kritickou hodnotu t-rozdělení (p = 0,05) pro daný počet stupňů volnosti sv vypočteme pomocí následujícího postupu s přesností na 6 platných míst.
t = 1,95994+ 2,37228/sv+ 2,82202/sv^2+ 2,56449/sv^3+ 1,51956/sv^4+ 1.02579/sv^5+ 0,44210/sv^7
- 8.1 Tabulka kritických hodnot F-rozdělení