| Součet odpovědí na nulovou dávku | B |
| Součet odpovědí na nižší dávku standardu | S1 |
| Součet odpovědí na vyšší dávku standardu | S2 |
| Součet odpovědí na nižší dávku testovaného přípravku | U1 |
| Součet odpovědí na vyšší dávku testovaného přípravku | U2 |
| Součet součinů pro standard | |
| Součet součinů pro testovaný přípravek | |
| Sklon regresní přímky standardu | |
| Sklon regresní přímky testovaného přípravku | |
| Kontrast nulové dávky | 1) |
| Kontrast průsečíků | 1) |
kde Bi je celková odpověď králíka z tabulky 3.2.8.4-II.
kde DI a DII jsou celkové odpovědi pro každý den.
Reziduální chyba mezi králíky = Bloky - Nerovnoběžnost - (Dny x Přípravky) - (Dny x Regrese) = 38 258,81.
Reziduální chyba "uvnitř" králíků = Celkem - Bloky - Dny - Přípravky - Regrese - (Dny x Nerovnoběžnost) = 3 844,06.
- Validita zkoušky
Analýza potvrzuje, že data splňují podmínky nutné pro použití zkoušky:
- 1. významnost regrese: testovací statistika pro regresi (64,5) vypočtená s použitím rozptylu tvořeného rozdíly mezi králíky je větší než kritická hodnota interpolovaná z tabulky 3.2.4-I pro P = 0,01 s f1 = 1 a f2 = 28;
- 2. odchylka od rovnoběžnosti regresních přímek: test rovnoběžnosti v křížovém pokusu není příliš citlivý. Je totiž založen na reziduální chybě mezi králíky a ta závisí na variabilitě mezi nimi. Testovací statistika (1,06) je menší než kritická hodnota interpolovaná z tabulky 3.2.4-I pro P = 0,05 s f1 = 1 a f2 = 28;
- 3. žádná z interakcí není statisticky významná, jednotlivé hodnoty F jsou 0,02, 0,04 a 3,25.
Výpočet účinnosti a mezí spolehlivosti
Podíl sousedních dávek je 2,0, tedy I = ln 2 = 0,69315. Podle tabulky 6.1 je t = 2,05 pro 28 stupňů volnosti (P = 0,95).
Odhad účinnosti se získá odlogaritmováním M. Účinnost je tedy 40,1 jednotek na mililitr.
Pro logaritmy mezí spolehlivosti se dostane:
Meze spolehlivosti jsou tedy 33,4 až 48,2 jednotek na mililitr.
- 3.3 Model poměru sklonů
Tento model je vhodný například pro mikrobiologické zkoušky, v nichž je nezávisle proměnnou koncentrace.
- 3.3.1 Podmínky validity
Stejně jako ve zkouškách založených na modelu rovnoběžnosti by se mělo testovat splnění podmínek 1, 2 a 3 kapitoly 3.1. Po přezkoušení platnosti podmínek 4B a 5B kapitoly 3.1 se může provést analýza rozptylu popsaná dále v kapitole 3.3.3.
Použití dále uvedených jednoduchých metod statistické analýzy vyžaduje splnění následujících podmínek:
- 1. standard i testovaný přípravek musí být testován pomocí dvou různých ředění;
- 2. musí existovat pátá skupina pokusných jednotek, které jsou bez ošetření.
- 3.3.2 Plán pokusu
Analýza modelu poměru sklonů se dá provést (2 + 2)dávkovou nebo (3 + 3)dávkovou zkouškou. Při celkově stejném počtu pokusných jednotek se však dá zmenšit rozptyl poměru účinností vytvořením skupiny bez ošetření (blank). Je tedy např. plán pětidávkových skupin se společnou skupinou bez ošetření vhodnější než (2 + 2)dávkový plán. Má minimální počet skupin uvažující ověření linearity závislosti na dávce pro oba přípravky. Přesnost odhadu účinnosti závisí na rozdělení pokusných jednotek do dávkových skupin a na volbě dávek. Přesnost odhadu účinnosti je možno zvýšit určitým nerovnoměrným rozdělením pokusných jednotek do skupin, což však snižuje přesnost indikace odchylky od linearity. Splnění následujících tří podmínek, kladených na plán pěti skupin se společnou skupinou bez ošetření, zajišťuje uspokojivou přesnost odhadu a vyhovující schopnost odhalení nelinearity:
- 1. všech pět skupin ošetření má stejný rozsah;
- 2. dávka standardu s2 je co možná nejvyšší dávkou, jejíž průměrná odpověď leží ještě v lineární části regresní křivky, nízká s1 je rovna její polovině;
- 3. dávky testovaného přípravku u1 a u2 jsou odvozeny z jeho deklarované účinnosti R.
Podobně jako v kapitole 3.2.2 se může použít plně či po blocích náhodný plán pokusu nebo latinský čtverec. Použití kteréhokoliv z těchto plánů vyžaduje podobnou úpravu postupu pro odhad reziduálního součtu čtverců jako u modelu rovnoběžnosti. K ní se dá využít tabulka 3.2.3-V.
Dále je popsána analýza zkoušky jednoho neznámého přípravku v porovnání se standardem. Analýzu se dvěma nebo více neznámými přípravky popsali Clarke11) a Barraclough12).
- 3.3.3 Analýza rozptylu
Tato zkouška se obvykle analyzuje pomocí modelu vícenásobné regrese:
kde y je odpověď a vS, vU jsou dávky standardu a testovaného přípravku.
Každou skupinu ošetření určují hodnoty vS a vU. Pro skupiny, které neobdržely dávku standardu, je vS = 0. Stejně pro testovaný přípravek. Ruční zpracování se zjednoduší kódováním nižší a vyšší dávky standardu i přípravku hodnotami 0,45, resp. 1,0. Použije-li se toto značení (jako v tabulce 3.3.3-I), musí se nakonec provést korekce vypočtené účinnosti a regresních koeficientů. Vzorce pro výpočet jsou v tabulce 3.3.3-I. Po zkontrolování odpovědí a případné transformaci odpovědi se vypočtou jejich součty. Je třeba podotknout, že sklony regresní přímky jak pro standard, tak i pro zkoušený přípravek se počítají odděleně. Takže nejsou nezávislé, protože obě zčásti závisí na odpovědích ve skupině bez ošetření. Kontrast průsečíků (LI) měří rozdíl odhadů odpovědí při nulové koncentraci, počítaných zvlášť pro standard i neznámý přípravek. Tímto kontrastem se testuje základní předpoklad modelu, tj. stejná odpověď při nulové dávce přípravků.
Kontrast nulové dávky (LB) měří odchylku průměrné odpovědi na nulovou dávku od odpovědi na nulovou dávku, vypočítané pouze z odpovědí na nenulové dávky obou přípravků.
Tyto vzorce se použijí k porovnání zdrojů variability pomocí součtů čtverců popsaných v tabulce 3.3.3-II. Podobně jako dříve se vypočte korekční člen K, čtverec celkového součtu dělený počtem odpovědí a ∑y2 součet čtverců všech odpovědí.
Tab. 3.3.3-I Vzorce pro pětibodovou zkoušku se společnou skupinou bez ošetření
- 1) LB a LI se nesmí zaměňovat s LS...LZ.
- → Tento vývojový diagram ilustruje jednotlivé kroky analýzy výsledků zkoušky. Při použití tohoto grafu k vytvoření počítačového programu se při konečném rozhodnutí o přijetí, zamítnutí nebo modifikaci testu přihlíží k podrobnějším výsledkům, které poskytl počítač.
- * Vypočte se odečtením všech součtů čtverců od celkového součtu čtverců.
Tab. 3.3.3-II Validita zkoušky
Tab. 3.3.3-I Vzorce pro pětibodovou zkoušku se společnou skupinou bez ošetření Tab. 3.3.3-II Validita zkoušky Zdroj variability Stupně volnosti Součet čtverců regrese 2 nulová dávka 1 průsečík 1 reziduální chyba 5n - 5 * celkem 5n -1 - 3.3.1 Podmínky validity
- 3.3.4 Test validity
Testovací statistiky pro test závislosti na dávce, kontrastu nulové dávky a kontrastu průsečíku se vypočtou dělením příslušných součtů čtverců jejich stupni volnosti a reziduálním rozptylem s2, který se získá dělením reziduálního součtu čtverců jeho stupni volnosti. Významnost těchto podílů (F-statistik) se zjistí porovnáním s kritickými hodnotami v tabulce 3.2.4-I.
Podmínky validity:
- 1. kontrast průsečíků nesmí být statisticky významný;
- 2. variabilita způsobená dávkou musí být vysoce statisticky významná (hladina významnosti musí být menší než 0,01);
- 3. kontrast nulové dávky nesmí být statisticky významný. Významnost tohoto kontrastu může být způsobena nelinearitou vztahu dávky a odpovědi pro velmi malé dávky. Pokud k tomu dojde při zavádění metody v laboratoři, může se zkouška vylepšit přidáním malé konstantní dávky standardu ke všem dávkám. Pro další analýzu se pak berou za dávky pouze dávky standardu a testovaného přípravku nad tímto konstantním pozadím. Dojde-li k tomu během rutinního hodnocení, měl by se analytik poradit se statistikem, jak analyzovat zkoušku po vyloučení nulové dávky. Prokáží-li příslušné testy validitu zkoušky, může být vypočtena účinnost a její meze spolehlivosti postupem popsaným v kapitole 3.3.5.
- 3.3.5 Odhad účinnosti a její meze spolehlivosti
Účinnost neznámého přípravku vyjádřená ve vyšší dávce standardu jako jednotce je:
Meze spolehlivosti jsou:
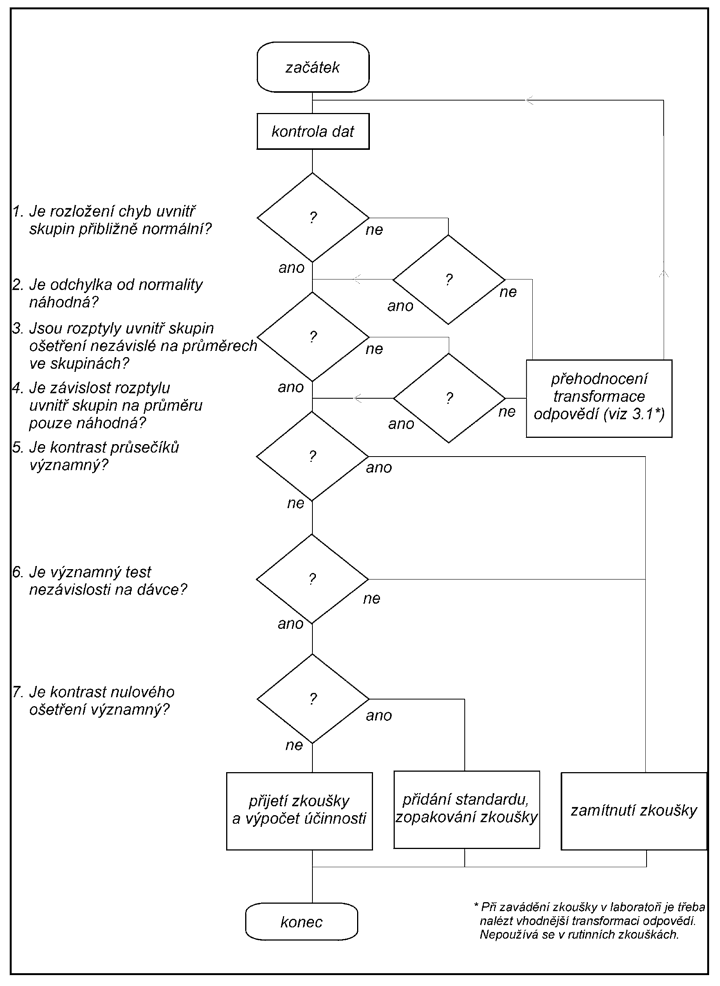
Obr. 3.3.4-I Vývojový diagram testů validity v rutinní zkoušce: model podílu sklonů
- kde:
Kritická hodnota t z tabulky 6.1 má stupně volnosti reziduálního rozptylu.
Účinnost zkoušeného přípravku se získá vynásobením relativní účinnosti a jejích mezí spolehlivosti vyšší dávkou standardu v obsahových jednotkách mezinárodního systému (viz obr. 3.3.5-I).
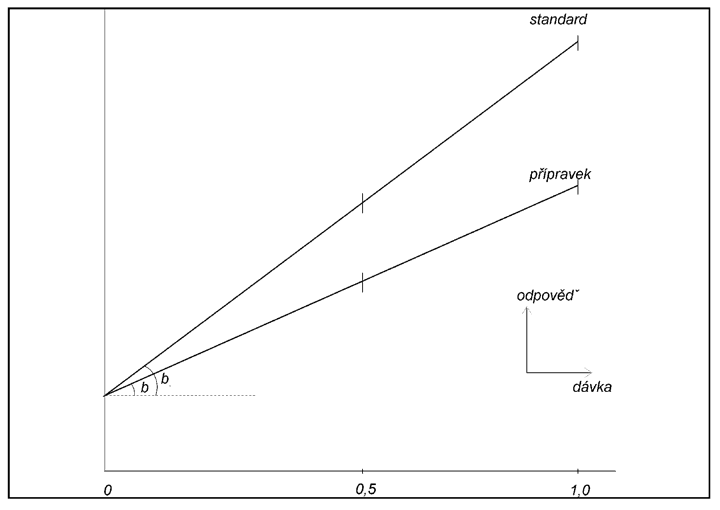
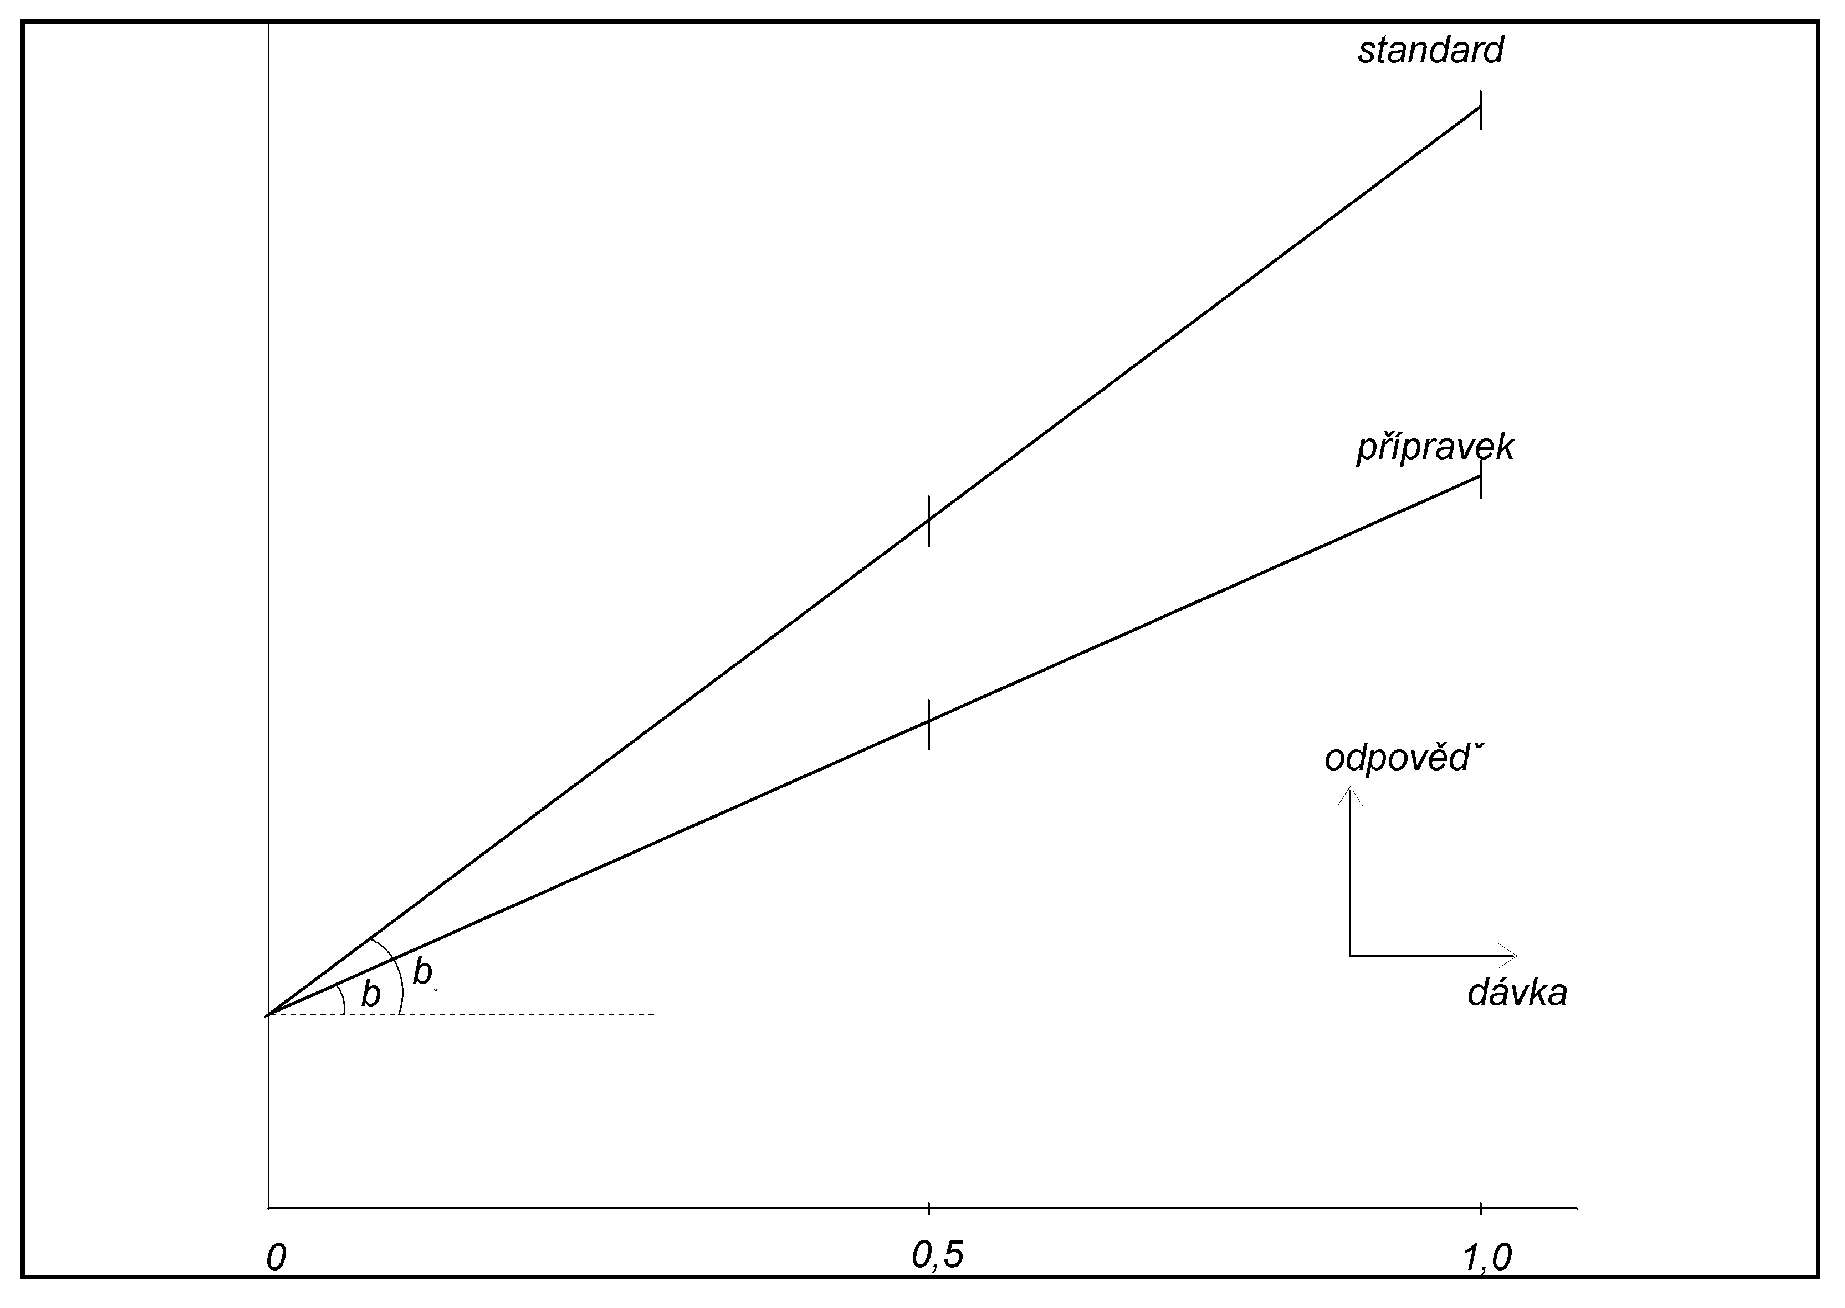
Obr. 3.3.5-I Model podílu sklonů, plán pěti skupin se společnou nulovou skupinou
Na základě deklarované účinnosti zkoušeného přípravku jsou jeho dávky u1 a u2 stanoveny tak, aby byly ekvivalentní dávkám standardu s1 a s2 dávky s2 a u2 jsou označeny hodnotou 1,0, dávky s1 a u1 hodnotou 0,5. Svislé úsečky vyjadřují rozpětí odpovědí v jednotlivých skupinách na dávky vyznačené na vodorovné ose. V tomto modelu mají regresní přímky závislosti odpovědi na dávce standardu a testovaného přípravku sklony bS a bU.
- 3.3.6 Chybějící hodnoty
Při náhradě chybějících dat se postupuje stejně jako v kapitole 3.2.6.
- 4 Kvantální zkoušky
- 4.1 Úvod
V některých zkouškách je nemožné nebo extrémně náročné měřit působení přípravku na každé pokusné jednotce. Místo toho je pozorován nějaký efekt působení přípravku na pokusné jednotky, jako například uhynutí nebo hypoglykemický symptom pokusných jednotek. Výsledek pak závisí na počtu jednotek, u kterých se projeví tento efekt. Takové zkoušky se nazývají kvantální "vše nebo nic".
Situace je velmi podobná kvantitativní zkoušce popsané v kapitole 3.1, ale místo n různých odpovědí v každé ošetřené skupině se získá pouze jediná hodnota, tj. procento jednotek s pozitivní odpovědí. Grafem závislosti tohoto procenta na logaritmu dávky je zpravidla spíše křivka tvaru S než přímka. Uspokojivějšího lineárního vztahu se dá dosáhnout transformací procenta pomocí vhodné matematické funkce. Nejpoužívanější je probitová transformace, další používané jsou arcsin a log-log transformace.
- 4.2 Probitová metoda
Podrobná statistická analýza lineární regresní závislosti transformované odpovědi na logaritmu dávky je velmi pracná. Dá se provést iteračně metodou maximální věrohodnosti. K dispozici jsou však počítačové programy. Tato analýza je popsána v mnohých učebnicích.
Za předpokladu, že je dostatečný počet odpovědí různých od nulových a stoprocentních, a za předpokladu, že není významná odchylka od linearity, dávají dostatečně přesné výsledky často již i prvé dva kroky probitové metody. Následující metoda se týká porovnání jednoho přípravku se standardem. Při porovnání více přípravků se standardem je nutná porada s biometrem. Výpočet se dá provést pomocí tabulek a kalkulačky. Kroky 1 až 5 poskytují první aproximaci, kroky 6 až 9 druhou. Kroky 10 až 11 obsahují test linearity a rovnoběžnosti závislosti probitu na logaritmu dávky pro standard a testovaný přípravek a v kroku 12 je počítán logaritmus účinnosti M’ a jeho meze spolehlivosti.
Stejná posloupnost kroků se dá použít k vytvoření počítačového programu s využitím modifikací popsaných na konci každého z následujících kroků.
Probit je jednoduchá lineární funkce standardní normální veličiny T. Počítačový program se dá sestavit s využitím následujících proměnných:
- 1. standardizovaná normální veličina T;
- 2. hustota D odpovídající hodnotě standardizované normální veličiny T, pro T = Ti je D = Di;
- 3. pravděpodobnost P, že veličina T má hodnotu nejvýše Ti (T ≤ Ti).
První algoritmus odhaduje T z hodnot P a druhý umožňuje získat odhady D a P odpovídající hodnotě T. Veličiny T, D a P se odhadují pro každou dávkovou skupinu i (Ti, Di a Pi).
- Postup
- 1. Sestavení tabulek výsledků
Použije se tabulka 4.2-I pro zapsání každé skupiny ošetření do sloupců označených čísly:
- 1. přípravek (standardní nebo testovaný),
- 2. X je logaritmus dávky (nebo jeho jednoduchý kód),
- 3. počet testovaných jedinců n při této dávce,
- 4. počet reagujících jedinců r při této dávce.
Počítačový program může obsahovat převod dávek na jejich logaritmus X.
- 2. Výpočet podílu (procenta) reagujících v dávkové skupině
Výpočet empirického podílu p = r/n a jeho zapsání do sloupce 5. Obvykle stačí dvě desetinná místa. Ošetřené skupiny s p = 0 a p = 1 se vyloučí.
- 3. Empirické probity
Z tabulky 4.2-II se získají pro každou skupinu ošetření empirické probity Ye odpovídající empirickému podílu p (vyjádřenému v procentech) a zapíší se do sloupce 6.
Pro výpočet empirických probitu se může použít algoritmus 4.2-I k vyjádření odpovědi tvaru Ye = T + 5 (tím se odstraní záporné odpovědi).
- 4. Nevážená lineární regrese odpovědi na logaritmu dávky
Počáteční odhad tohoto vztahu se může získat buď graficky (viz obr. 4.3-I), nebo početně. Při použití první metody se nejprve sestrojí bodový graf hodnot Ye v závislosti na X a získanými body se zvlášť pro standardní a testovaný přípravek "od oka" proloží rovnoběžné přímky s větším důrazem na body s empirickými probity mezi 4,0 a 6,0 než na body mimo tyto meze.
Druhý způsob spočívá v proložení přímek metodou nevážené lineární regrese. Vypočtou se:
(dvojitě jsou označeny součty pro všechny skupiny ošetřené standardním nebo zkoušeným přípravkem dohromady),
(Parametr se vypočte zvlášť pro standardní a zkoušený přípravek.)
Počítačový program používá k získání regresních parametrů a a b rovněž tyto vzorce.
- 5. První aproximace očekávaných probitů
Při použití grafické metody se na přímkách pro obě ošetření na grafu odečtou hodnoty F a zapíší se do sloupce 7.
Při použití početní metody poskytuje počáteční aproximaci Yi ke každé hodnotě X zvlášť pro standardní a testovaný přípravek rovnice:
Stejná rovnice se užívá i v počítačovém programu.
- 6. Váhové koeficienty
Pro každé YI se v tabulce 4.2.-III najde hodnota váhového koeficientu w a zapíše se do sloupce (8), součin nw pak do sloupce (9). Všechny hodnoty nw se udávají na stejný počet desetinných míst. Obvykle stačí jedno desetinné místo.
V počítačovém programu se k výpočtu váhových koeficientů použije algoritmus 4.2-II (viz dále): k vstupním hodnotám které odpovídají hodnotám Yi, se vypočtou hodnoty Pi a Di. Z nich se vypočtou váhy wi pro každou hodnotu Yi podle vzorce:
- 7. Pracovní probity
Pomocí tabulky 4.2.-III a následujících vzorců se vypočtou pracovní probity yi pro všechny skupiny i:
Y0, Y1 a A značí minimální probit, maximální probit a rozsah, P je pravděpodobnost příslušná k první aproximaci empirického probitu YI Pracovní probity, se zapíše do sloupce (10) v tabulce 4.2-I. Obvykle stačí dvě desetinná místa. Jejich počet by měl být stejný pro všechny ošetřené skupiny.
Pro počítačový program jsou vhodné následující dva vzorce pro pracovní probity yi odpovídající hodnotám YI:
Hodnota Di odpovídá empirickému podílu pi (jakožto pravděpodobnosti).
- 8. Vážené průměry, součty čtverců a součty součinů
Pro všechna ošetření se vytvoří součiny nwy, nwX a nwXy a zapíší se do sloupců (11), (12) a (13). Zvlášť pro standard a přípravek se vypočtou součty sloupců (9), (11) a (12) a z nich vážené průměry:
Dále se vypočtou součiny nwX2, nwy2 a nwXy, z nich vážené součty čtverců 2X a2y a součty součinů Xy, opět zvlášť pro standard a testovaný přípravek. S jejich pomocí se vypočtou veličiny Sxx, SXy a Syy podle těchto vzorců:
Stejné vzorce se použijí i v počítačovém programu.
- 9. Druhá a další aproximace probitu
Pro druhou (lineární) aproximaci probitu se nejprve vypočte společný parametr sklonu b2 podle vzorce:
(Sčítají se hodnoty pro standardní a zkoušený přípravek.)
Tato hodnota se použije k výpočtu parametru a2 zvlášť pro každý z přípravků:
Tak se získá druhá aproximace YII pro standard a přípravek odděleně ve tvaru dvou regresních přímek:
Podle těchto rovnic se vypočtou hodnoty YII pro všechny skupiny ošetřované oběma přípravky a porovnají se s odpovídajícími hodnotami YI. Jsou-li alespoň některé rozdíly mezi nimi velké, např. větší než 0,1 při počítání na jedno desetinné místo, vypočte se další aproximace zopakováním kroků 6 až 9, přičemž se všechny hodnoty YI nahradí příslušnými hodnotami YII. Stejně se postupuje i tehdy, jeví-li uvedené rozdíly závislost na dávce.
V počítačovém programu se vypočtou pro všechny ošetřené skupiny čtverce rozdílů YII - YI a jejich součet. Je-li tento součet čtverců větší než například 10-7, nahradí se všechny hodnoty YI příslušnými hodnotami YII a opakují se kroky 6 až 9.
- 10. Test odchylky od linearity
Ve zkoušce alespoň se třemi dávkami pro každý přípravek se dá testovat významnost odchylky od linearity pomocí statistiky:
s f = (k - 4) stupni volnosti. Odpovídající kritické hodnoty jsou v tabulce 6.2. Při významné hodnotě χ2 je nutno konzultovat vyhodnocení zkoušky se statistikem. Počítačový program může poskytnout obsluze vypočtený χ2 a příslušné stupně volnosti bez dalšího komentáře. Jiná možnost je vytvořit soubor kritických hodnot z podprogramu, který vypočte aproximaci pravděpodobnosti překročení hodnoty χ2 Vhodné vzorce k těmto výpočtům jsou v knize Abramowitz a Stegun13).
- 11. Test odchylky od rovnoběžnosti
Pokud se neprokázala významná odchylka od linearity, pak se testuje ještě rovnoběžnost pomocí statistiky:
s jedním stupněm volnosti.
- 12. Výpočet účinnosti a jejích mezí spolehlivosti
Při nevýznamné odchylce od rovnoběžnosti je možno počítat logaritmus účinnosti M´podle vzorce:
Účinnost je pak antilogaritmus M´ (exp(M´)). Meze spolehlivosti se vypočtou jako antilogaritmy hodnot:
kde
Je patrná analogie těchto výrazů s výrazem 3.2.5-4 pro výpočet mezí spolehlivosti ve zkouškách účinnosti s kvantitativní odpovědí. Součet čtverců pro regresi v kapitole 3.2.3 se dá psát ve tvaru:
Při probitové transformaci je reziduální rozptyl odpovědí roven jedné. Kritická hodnota t s ∞ stupni volnosti se najde v tabulce 6.1.
Pro nekonečný počet stupňů volnosti má veličina t standardní normální rozdělení, takže počítačový program může počítat požadovanou hodnotu t algoritmem 4.2-I s pravděpodobností P odpovídající polovině požadované hladiny významnosti.
- 1. Sestavení tabulek výsledků
Algoritmus 4.2-I
Algoritmus požaduje jako vstup pravděpodobnost Pi a počítá Ti aproximované pomocí:
kde:
Tab. 3.3.3-I Vzorce pro pětibodovou zkoušku se společnou skupinou bez ošetření Tab. 3.3.3-II Validita zkoušky Algoritmus 4.2-I a0 = 2,515517 b0 = 1,0 a1 = 0,802853 b1 = 1,1432788 a2 = 0,010328 b2 = 20,189269 b3 = 0,001308 Je-li P > 0,5, dosadí se ve vzorci pro w za P hodnota (1 - P) a výsledné Ti se vynásobí -1.
Tento a následující algoritmus jsou převzaty z příručky Abramowitze a Steguna14).
Algoritmus 4.2-II
Algoritmus požaduje Ti jako vstup a počítá hustotu D a aproximaci P pomocí následujících formulí:
kde:
- a1 = 0,3193815
- a2 = -0,3565638
- a3 = 1,781478
- a4 = -1,821256
- a5 = 1,330724
Je-li Ti < 0, dosadí se ve vzorci pro w za Ti hodnota -Ti a místo vypočtené hodnoty P, se vezme 1 – Pi.
Tab. 4.2-I Výsledné veličiny
Tab. 3.3.3-I Vzorce pro pětibodovou zkoušku se společnou skupinou bez ošetření Tab. 3.3.3-II Validita zkoušky Algoritmus 4.2-I Algoritmus 4.2-II Tab. 4.2-I Výsledné veličiny Přípravek X n r p Ye YI w nw y nwy nwX nwXy YII (1) (2) (3) (4) (5) (6) (7) (8) (9) (10) (11) (12) (13) (14) Tab. 4.2-II Probity odpovídající procentům P
Tab. 3.3.3-I Vzorce pro pětibodovou zkoušku se společnou skupinou bez ošetření Tab. 3.3.3-II Validita zkoušky Algoritmus 4.2-I Algoritmus 4.2-II Tab. 4.2-I Výsledné veličiny Tab. 4.2-II Probity odpovídající procentům P p 0 1 2 3 4 5 6 7 8 9 0 — 2,67 2,95 3,12 3,25 3,36 3,45 3,52 3,59 3,66 10 3,72 3,77 3,82 3,87 3,92 3,96 4,01 4,05 4,08 4,12 20 4,16 4,19 4,23 4,26 4,29 4,33 4,36 4,39 4,42 4,45 30 4,48 4,50 4,53 4,56 4,59 4,61 4,64 4,67 4,69 4,72 40 4,75 4,77 4,80 4,82 4,85 4,87 4,90 4,92 4,95 4,97 50 5,00 5,03 5,05 5,08 5,10 5,13 5,15 5,18 5,20 5,23 60 5,25 5,28 5,31 5,33 5,36 5,39 5,41 5,44 5,47 5,50 70 5,52 5,55 5,58 5,61 5,64 5,67 5,71 5,74 5,77 5,81 80 5,84 5,88 5,92 5,95 5,99 6,04 6,08 6,13 6,18 6,23 90 6,28 6,34 6,41 6,48 6,55 6,64 6,75 6,88 7,05 7,33 0,0 0,1 0,2 0,3 0,4 0,5 0,6 0,7 0,8 0,9 99 7,33 7,37 7,41 7,46 7,51 7,58 7,65 7,75 7,88 8,09 Tab. 4.2-III Minimální a maximální pracovní probity, rozsah a váhové koeficienty
Tab. 3.3.3-I Vzorce pro pětibodovou zkoušku se společnou skupinou bez ošetření Tab. 3.3.3-II Validita zkoušky Algoritmus 4.2-I Algoritmus 4.2-II Tab. 4.2-I Výsledné veličiny Tab. 4.2-II Probity odpovídající procentům P Tab. 4.2-III Minimální a maximální pracovní probity, rozsah a váhové koeficienty Empirický probit Minimální pracovní
probitRozsah Maximální pracovní probit Empirický probit Váhy Ye Y0 A Y1 Ye w 1,1 0,8579 5034,0 9,1421 8,9 0,00082 1,2 0,9522 3425,0 9,0478 8,8 0,00118 1,3 1,0462 2354,0 8,9538 8,7 0,00167 1,4 1,1400 1634,0 8,8600 8,6 0,00235 1,5 1,2334 1146,0 8,7666 8,5 0,00327 1,6 1,3266 811,5 8,6734 8,4 0,00451 1,7 1,4194 580,5 8,5806 8,3 0,00614 1,8 1,5118 419,4 8,4882 8,2 0,00828 1,9 1,6038 306,1 8,3962 8,1 0,01104 2,0 1,6954 225,6 8,3046 8,0 0,01457 2,1 1,7866 168,00 8,2134 7,9 0,01903 2,2 1,8771 126,34 8,1228 7,8 0,02458 2,3 1,9673 95,96 8,0327 7,7 0,03143 2,4 2,0568 73,62 7,9432 7,6 0,03977 2,5 2,1457 57,05 7,8543 7,5 0,04979 2,6 2,2339 44,654 7,7661 7,4 0,06168 2,7 2,3214 35,302 7,6786 7,3 0,07564 2,8 2,4081 28,189 7,5919 7,2 0,09179 2,9 2,4938 22,736 7,5062 7,1 0,11026 3,0 2,5786 18,522 7,4214 7,0 0,13112 3,1 2,6624 15,2402 7,3376 6,9 0,15436 3,2 2,7449 12,6662 7,2551 6,8 0,17994 3,3 2,8261 10,6327 7,17316 6,7 0,20774 3,4 2,9060 9,0154 7,0940 6,6 0,23753 3,5 2,9842 7,7210 7,0158 6,5 0,26907 3,6 3,0606 6,6788 6,9394 6,4 0,30199 3,7 3,1351 5,8354 6,8649 6,3 0,33589 3,8 3,2074 5,1497 6,7926 6,2 0,37031 3,9 3,2773 4,5903 6,7227 6,1 0,40474 4,0 3,3443 4,1327 6,6557 6,0 0,43863 4,1 3,4083 3,7582 6,5917 5,9 0,47144 4,2 3,4687 3,4519 6,5313 5,8 0,50160 4,3 3,5251 3,2025 6,4749 5,7 0,53159 4,4 3,5770 3,0010 6,4230 5,6 0,55788 4,5 3,6236 2,8404 6,3764 5,5 0,58099 4,6 3,6643 2,7154 6,3357 5,4 0,60052 4,7 3,6982 2,6220 6,3018 5,3 0,61609 4,8 3,7241 2,5573 6,2759 5,2 0,62742 4,9 3,7407 2,5192 6,2593 5,1 0,63431 5,0 3,7467 2,5066 6,2533 5,0 0,63662 5,1 3,7401 2,5192 6,2599 4,9 0,63431 5,2 3,7186 2,5573 6,2814 4,8 0,62742 5,3 3,6798 2,6220 6,3202 4,7 0,61609 5,4 3,6203 2,7154 6,3797 4,6 0,60052 5,5 3,5360 2,8404 6,4640 4,5 0,58099 5,6 3,4220 3,0010 6,5780 4,4 0,55788 5,7 3,2724 3,2025 6,7276 4,3 0,53159 5,8 3,0794 3,4519 6,9206 4,2 0,50260 5,9 2,8335 3,7582 7,1665 4,1 0,47144 6,0 2,5230 4,1327 7,4770 4,0 0,43863 6,1 2,1324 4,5903 7,8676 3,9 0,40474 6,2 1,6429 5,1497 8,3571 3,8 0,37031 6,3 1,0295 5,8354 8,9705 3,7 0,33589 6,4 0,2606 6,6788 9,7394 3,6 0,30199 6,5 -0,7052 7,7210 10,7052 3,5 0,26907
- 4.3 Příklad
- Zkouška insulinu na myších podkožním podáním
Standardní přípravek byl podáván v dávkách 0,024 a 0,04 jednotek na myš v dávce o objemu 0,25ml. Odpovídající dávka přípravku U byla připravena na základě deklarované účinnosti AU = 40 jednotek na ml. Každá dávka byla podána dvaceti čtyřem jedincům.
Kladná odpověď byla definována jako hypoglykemická křeč v průběhu 75 minut po podkožním podání insulinu.
V tabulce 4.3-I je počet (r) jedinců každé skupiny reagujících kladně, společně s podílem odpovědí p a odpovídajícím probitem z tabulky 4.2-II.
Tab. 4.3-I Odpovědi a empirické probity
Tab. 3.3.3-I Vzorce pro pětibodovou zkoušku se společnou skupinou bez ošetření Tab. 3.3.3-II Validita zkoušky Algoritmus 4.2-I Algoritmus 4.2-II Tab. 4.2-I Výsledné veličiny Tab. 4.2-II Probity odpovídající procentům P Tab. 4.2-III Minimální a maximální pracovní probity, rozsah a váhové koeficienty Tab. 4.3-I Odpovědi a empirické probity Přípravek Dávka ln (dávky) = x n r p = r/n empirický probit, y standard S s2 3,689 24 21 0,88 6,18 s1 3,178 24 8 0,33 4,56 přípravek
Uu1 3,689 24 20 0,83 5,95 u2 3,178 24 10 0,42 4,80 celkem 13,734 21,49
- První aproximace probitů
První aproximace může být získána jedním z dvou následujících způsobů:
- 1. graficky, nakreslením probitů z tabulky 4.3-I proti ln (dávky) do bodového grafu a proložením "podle oka" dvou rovnoběžných přímek (kapitola 4.2, krok 4-5) pro standard a zkoušený přípravek a odečtením hodnot aproximovaných probitů na těchto přímkách;
- 2. výpočtem těchto přímek metodou nevážené lineární regrese.
V příkladu se postupuje druhou metodou, jejíž použití je pro počítače vhodnější a navíc poskytuje při opakovaném výpočtu stejné výsledky. V použitém příkladu je obtížné odhadnout rovnoběžné přímky od oka, protože spojnice bodů pro standard a bodů pro zkoušený přípravek se protínají.
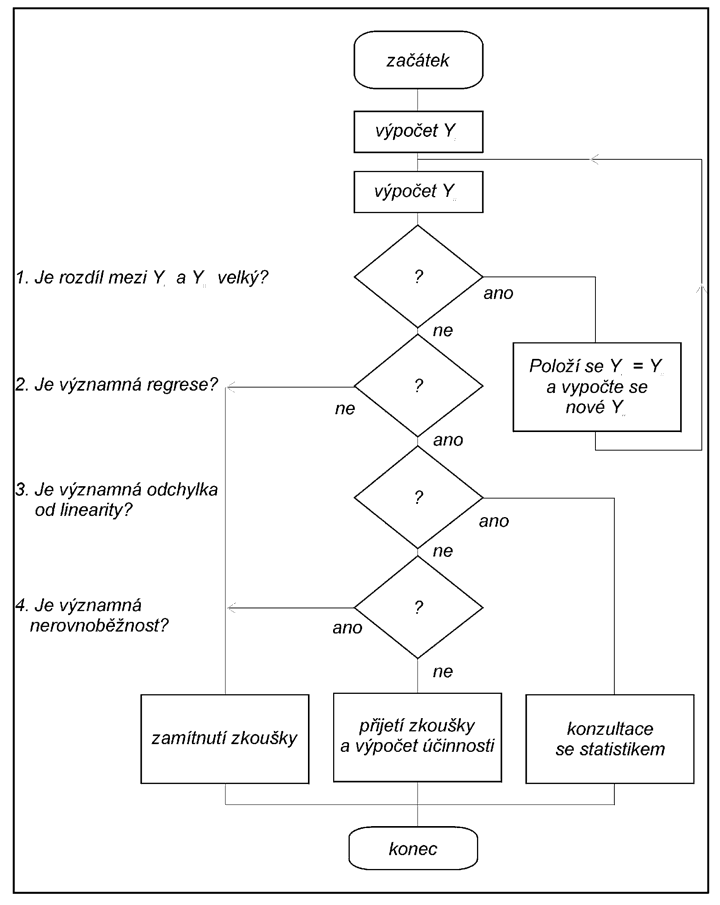
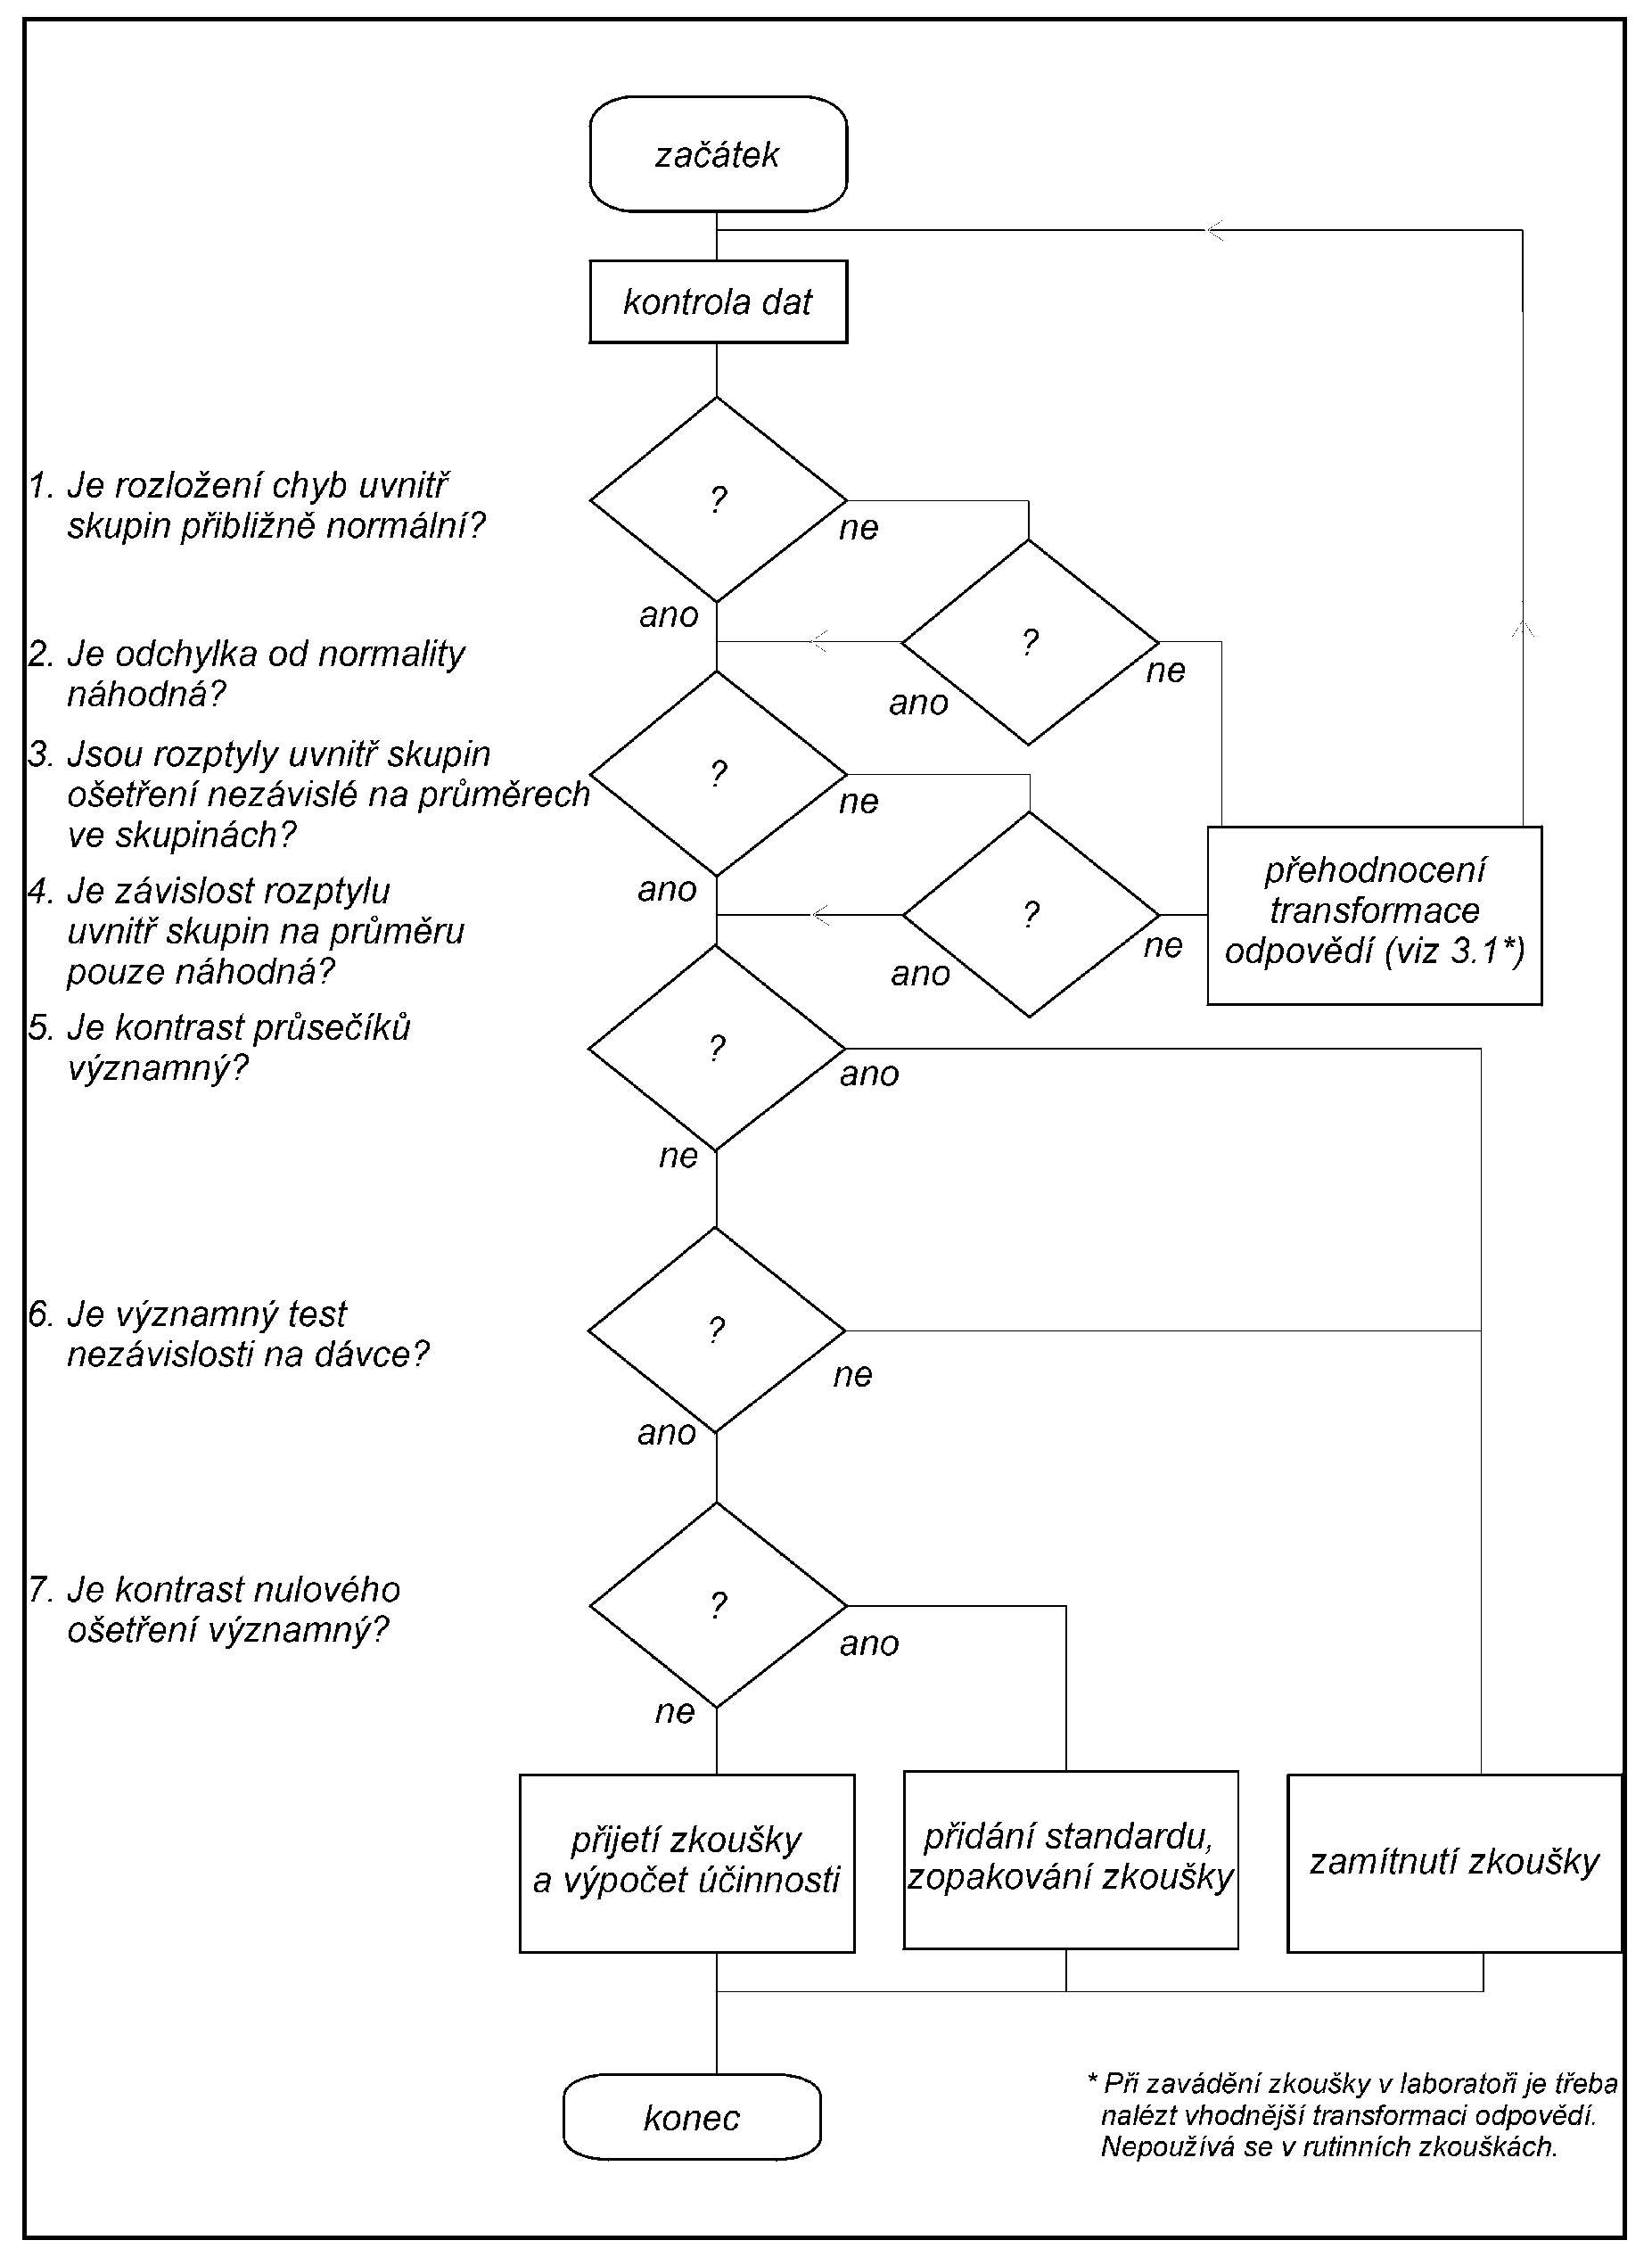
Algoritmus 4.2-III Vývojový diagram testů validity v rutinní kvantální zkoušce
Vývojový diagram zobrazuje logické kroky při hodnocení výsledků kvantální zkoušky.
Je-li na základě tohoto diagramu vytvořen program, musí výsledné rozhodnutí (přijmout, zamítnout nebo modifikovat zkoušku) provést experimentátor na základě detailních výsledků poskytnutých počítačem.
Společný sklon rovnoběžných regresních přímek se vypočte podle vzorce:
kde k je počet všech ošetřených skupin, sčítá se přes všechny skupiny,
x = ln (dávky)
y = empirický probit (tabulka 4.3-I)
Parametry a obou přímek udává rovnice:
Rovnice regresních přímek jsou Y = a + bx (viz obr. 4.3-I).
Přímka standardu je Y = -3,936 + 2,711x a přímka přípravku U Y = -3,931 + 2,711x.
Očekávané probity YI se získají dosazením hodnot 3,689 a 3,178 za x do odpovídajících rovnic. Tyto hodnoty jsou uvedeny v tabulce 4.3.-II společně s vahami w, minimálním pracovním probitém Y0 a rozsahem A interpolovaným podle tabulky 4.2-III. Pracovní probity y se vypočtou podle rovnice:
Tab. 4.3-II Očekávané probity
Tab. 3.3.3-I Vzorce pro pětibodovou zkoušku se společnou skupinou bez ošetření Tab. 3.3.3-II Validita zkoušky Algoritmus 4.2-I Algoritmus 4.2-II Tab. 4.2-I Výsledné veličiny Tab. 4.2-II Probity odpovídající procentům P Tab. 4.2-III Minimální a maximální pracovní probity, rozsah a váhové koeficienty Tab. 4.3-I Odpovědi a empirické probity Algoritmus 4.2-III Vývojový diagram testů validity v rutinní kvantální zkoušce Tab. 4.3-II Očekávané probity Přípravek x p YI w Y0 A y standard S 3,689
3,1780,88
0,336,06
4,680,418
0,6132,289
3,6914,407
2,6416,167
4,563přípravek U 3,689
3,1780,83
0,426,07
4,680,415
0,6132,250
3,6914,453
2,6415,946
4,800Pro hodnocení standardního a testovaného přípravku se vypočtají následující statistiky:
Tab. 3.3.3-I Vzorce pro pětibodovou zkoušku se společnou skupinou bez ošetření Tab. 3.3.3-II Validita zkoušky Algoritmus 4.2-I Algoritmus 4.2-II Tab. 4.2-I Výsledné veličiny Tab. 4.2-II Probity odpovídající procentům P Tab. 4.2-III Minimální a maximální pracovní probity, rozsah a váhové koeficienty Tab. 4.3-I Odpovědi a empirické probity Algoritmus 4.2-III Vývojový diagram testů validity v rutinní kvantální zkoušce Tab. 4.3-II Očekávané probity Jejich hodnoty jsou v tabulce 4.3-III.
Tab. 4.3-III
Tab. 3.3.3-I Vzorce pro pětibodovou zkoušku se společnou skupinou bez ošetření Tab. 3.3.3-II Validita zkoušky Algoritmus 4.2-I Algoritmus 4.2-II Tab. 4.2-I Výsledné veličiny Tab. 4.2-II Probity odpovídající procentům P Tab. 4.2-III Minimální a maximální pracovní probity, rozsah a váhové koeficienty Tab. 4.3-I Odpovědi a empirické probity Algoritmus 4.2-III Vývojový diagram testů validity v rutinní kvantální zkoušce Tab. 4.3-II Očekávané probity Tab. 4.3-III Přípravek Σnw Σnwx Σnwy Σnwxy Σnwx2 Sxx Sxy x̄ ȳ standard 24,744 83,763 128,998 441,571 285,109 1,5558 4,8890 3,3852 5,1133 přípravek U 24,672 83,497 129,840 442,892 284,128 1,5506 3,4769 3,3843 5,2626 součet 49,416 3,1064 8,3659 Druhá aproximace parametrů dvojice regresních přímek je:
Takže přímka standardu je Y = -3,903 + 2,693x
a přímka přípravku U je Y = -3,851 + 2,693x.
Očekávané probity odečtené z těchto přímek jsou tedy 6,03, 4,66, 6,08 a 4,71 pro dávky s2, s1, u2 a u1.
- Zkouška insulinu na myších podkožním podáním
- 4.1 Úvod